직관 — 한 문서의 반복과 여러 문서의 흔함을 함께 본다
모든 여행 후기에 쓰인 인사말보다 한 장소에서만 반복되는 특징이 검색에 도움이 될 수 있다. 먼저 후기 안에서 몇 번 나왔는지 센다. 다음으로 전체 후기 중 얼마나 널리 쓰였는지를 보고 가중치를 붙인다.
단어가방 모형의 횟수에 문서 모음 전체의 정보를 더한 것이 TF-IDF다. 인공지능이 문서에서 핵심어를 뽑거나 검색 결과의 순서를 정할 때 쓰는 대표적인 가중치다. 같은 이름이라도 책이나 도구에 따라 정규화·로그 사용 여부가 다르므로, 이 글은 씨마스 2022 개정 교과서의 횟수 TF와 인 IDF를 사용한다.
TF-IDF의 교과 모형은 TF에 상대 문서 빈도의 역수를 곱한다
문서 수가 인 고정된 문서 모음을 생각하자. 단어 가 나온 문서의 개수를 라 하고, 적어도 한 문서에 있는 단어만 어휘로 삼는다. 그러면 이다.
| 기호 | 이름 | 원어 | 뜻 |
|---|---|---|---|
| 전체 문서 수 | corpus size | 점수를 정하는 기준 문서 모음의 크기 | |
| 문서 빈도수 | document frequency, DF | 단어 가 한 번 이상 나온 문서의 개수 | |
| 상대 문서 빈도 | relative document frequency | 전체 문서 중 를 포함하는 문서의 비율 | |
| 단어 빈도수 | term frequency | 문서 안에서 가 나온 횟수 | |
| 역문서 빈도수 | inverse document frequency | 이 글에서는 의 역수 | |
| 중요도 점수 | TF-IDF weight | 같은 단어의 TF와 IDF를 곱한 값 |
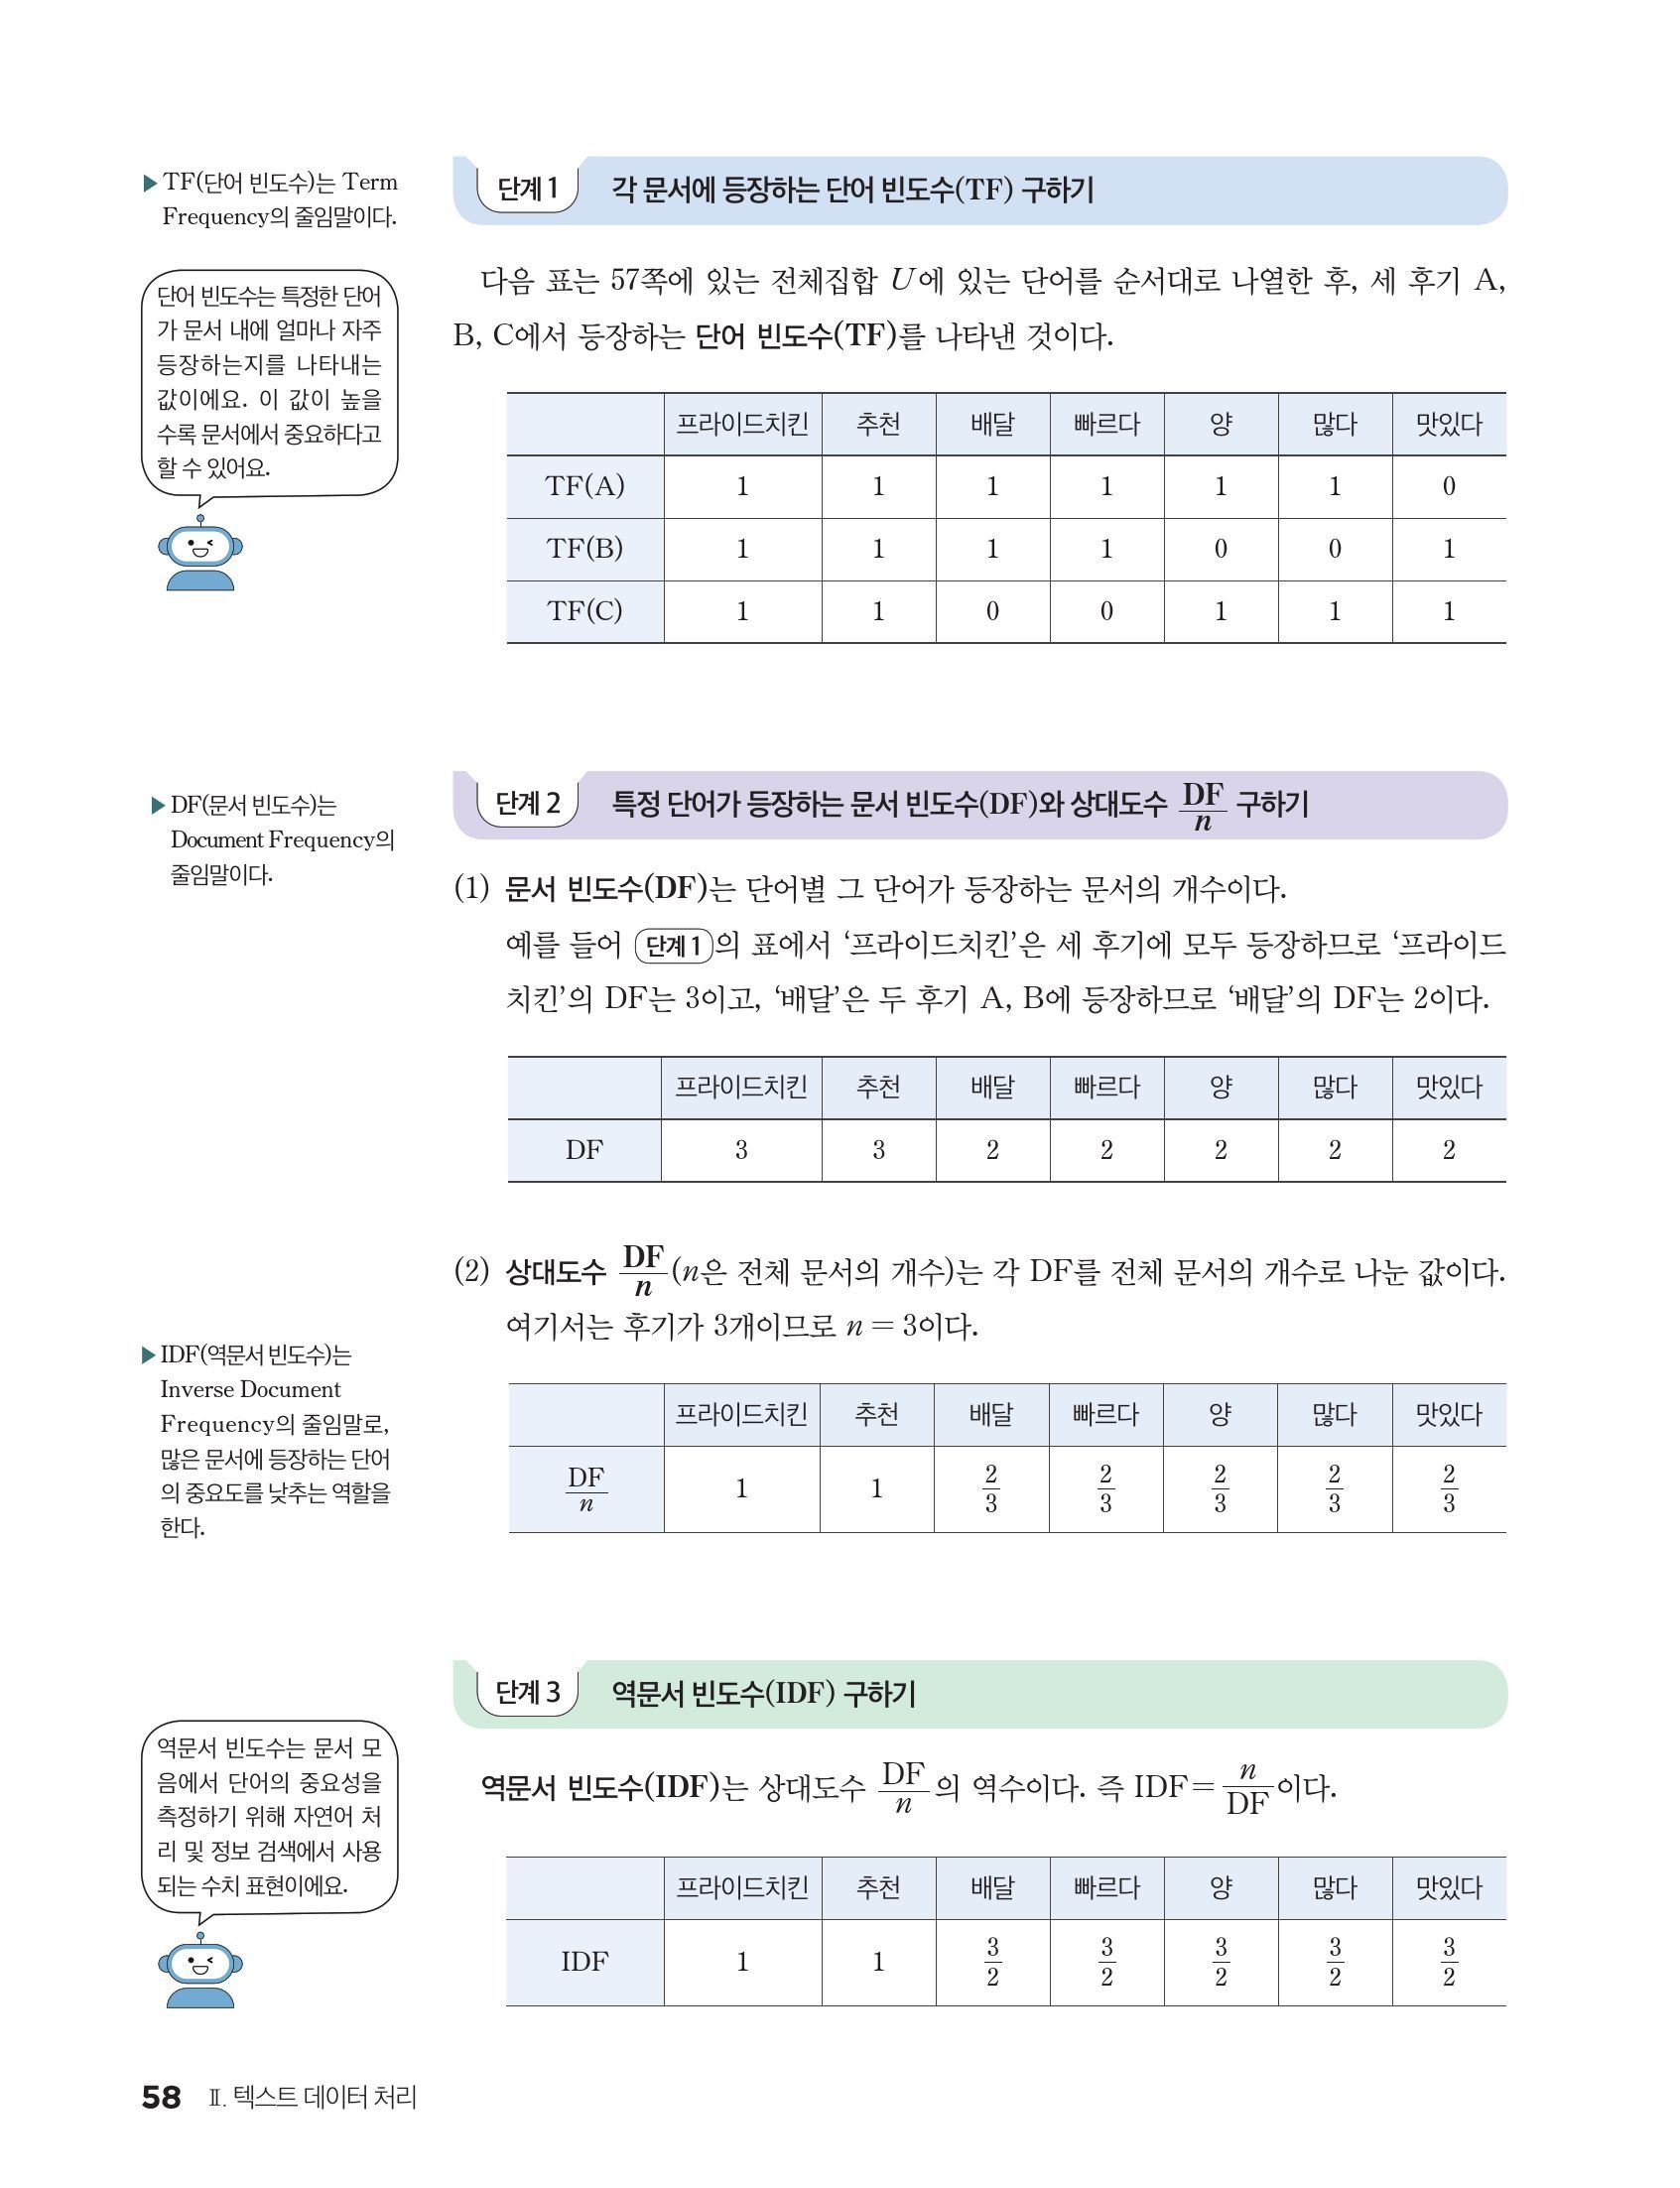
교과서는 전체 문서 수를 , 문서 빈도수를 DF로 쓴다. 이 페이지의 , 와 같다. 교과서의 계산은 다음 네 단계다.
- 문서마다 TF를 구한다.
- 단어마다 DF와 상대도수 을 구한다.
- 그 역수인 IDF를 구한다.
- 같은 칸끼리 TF와 IDF를 곱한다.
문서 빈도수는 개수 이고, 그 상대도수는 비율 이다. 여기서는 비율의 역수를 쓰므로 가 된다. 개수의 역수 와 수치가 같지 않다. 이 고정되어 있다면 두 방식의 점수는 일정한 배 차이지만, 계산 답을 대조할 때는 그 차이를 없던 것으로 해서는 안 된다.
TF-IDF의 문서 빈도는 단어가 나온 횟수와 어떻게 다를까?
문서 빈도 는 단어가 나온 문서의 개수이고, 한 문서 안의 반복은 세지 않는다. 그래서 한 단어의 TF를 문서별로 더한 값은 보다 작아지지 않는다. 그 단어가 있는 문서는 TF 합에는 1 이상을, 에는 정확히 1을 보태기 때문이다.
앞 글의 처리 후 문서를 다시 사용한다. A는 ‘숲 산책 숲 좋다’, B는 ‘바다 산책 좋다’, C는 ‘바다 바다 조용하다’다. 문서 수 이고 어휘 순서는 숲·바다·산책·좋다·조용하다로 고정한다.
‘바다’는 B에 한 번, C에 두 번 나와 TF의 합은 3이지만 포함 문서는 B와 C 두 개다. 따라서 이다. 그림 1에서 숲·바다는 TF 합이 보다 크고, 한 문서에 한 번씩만 나온 산책·좋다·조용하다는 둘이 같다.

figures/df_vs_total_tf.py이미 그 단어가 있던 문서에 반복을 열 번 더해도 그 문서의 TF만 커지고 는 그대로다. C에 ‘바다’를 열 번 더 써도 다. 그 단어가 없던 문서에 처음 넣어야 가 1 커진다.
세 문서의 TF-IDF를 한 칸씩 계산해 보자
TF 표에서 0보다 큰 칸을 단어마다 세어 를 구하고, 로 IDF를 정한다. 그다음 TF와 IDF를 같은 열끼리 곱한다.
| 구분 | 숲 | 바다 | 산책 | 좋다 | 조용하다 |
|---|---|---|---|---|---|
| TF(A) | 2 | 0 | 1 | 1 | 0 |
| TF(B) | 0 | 1 | 1 | 1 | 0 |
| TF(C) | 0 | 2 | 0 | 0 | 1 |
| DF | 1 | 2 | 2 | 2 | 1 |
| IDF | 3 | 3 |
A의 ‘숲’은 TF가 2이고, 그 단어가 있는 문서는 A 하나이므로 IDF가 이다. A의 세 칸을 계산하면 다음과 같다.

figures/weight_steps.py식 (2)와 같은 방법으로 모든 칸을 채우면 A는 , B는 , C는 이다. 그림 2는 A의 횟수와 가중치를 구분해 보여 준다. 0은 그 문서에서 단어가 없어서 생긴 것이며, 흔한 단어라서 0이 되는 것은 아니다.
TF-IDF에서 덜 흔한 단어의 가중치는 왜 클까?
양수 가 작을수록 같은 을 나눈 몫 가 커지기 때문이다. 한 문서에만 있으면 IDF는 , 모든 문서에 있으면 이다. 이 자료에서 ‘좋다’가 C에도 있었다면 이 되어 IDF는 이다.
따라서 이 관례에서는 이며 흔한 단어도 가중치가 0이 되지 않는다. 단, TF가 더 큰 단어가 있으므로 희소성만으로 최종 점수 순서가 결정되지는 않는다.
또한 ‘드물다’와 ‘의미가 중요하다’는 같은 말이 아니다. 한 문서에만 들어간 오타도 높은 가중치를 받을 수 있다. 점수로 후보를 좁힌 뒤 원문에서 실제 의미를 확인해야 한다.
TF-IDF로 문서마다 핵심어를 고른다
TF-IDF는 한 문서 안의 단어를 비교하는 데 쓴다. 문서마다 TF-IDF가 큰 단어를 그 문서의 핵심어 후보로 고른다. 교과서도 이렇게 고른 단어로 각 후기를 요약한다.

figures/keyword_tables.py그림 3에서 A의 핵심어는 TF-IDF가 6인 ‘숲’이다. B는 바다·산책·좋다가 모두 라 이 자료만으로는 하나를 고를 수 없다. C에서 ‘바다’는 TF가 2지만 B에도 있어 IDF가 이고, ‘조용하다’는 TF가 1이지만 C에만 있어 IDF가 3이다. 그래서 TF로는 바다가 두 배였던 두 단어가 TF-IDF로는 3으로 같아진다.
TF-IDF의 교과 모형은 문서 내 횟수에 를 곱한다. 모든 문서에 있는 단어의 IDF는 1이며, TF-IDF가 0이 되려면 그 문서에서의 TF가 0이어야 한다.
TF-IDF는 몇 이상이면 중요한 단어일까?
TF-IDF에는 중요한 단어를 가르는 정해진 기준값이 없다. 교과서도 분석 목적에 따라 문서 안에서 상대적인 기준을 정하라고 안내한다. 이 글의 A에서는 6인 ‘숲’이, C에서는 3인 바다·조용하다가 가장 크다.
TF-IDF 도구의 답이 이 계산과 다른 이유는 무엇일까?
TF-IDF 도구는 로그를 쓰거나, 0으로 나누는 일을 피하려 수를 더하거나, 벡터 전체 길이를 정규화해 이 글의 계산과 답이 다를 수 있다. 이 글의 와 다른 정의를 쓴 결과를 곧바로 오답이라고 판단하지 않는다. 로그형은 아래 ‘대수를 배웠다면’ 절에서 따로 비교한다.
새 검색어가 들어오면 TF-IDF의 문서 수도 바꿀까?
이 글의 검색 활동에서는 기준 문서 모음과 DF를 고정하고 새 검색어나 새 문서의 TF만 계산한다. ‘바다 별빛 바다’는 TF가 이고 TF-IDF는 이며, 기준 어휘에 없는 ‘별빛’은 제외 목록에 따로 남긴다. 자료 모음 자체를 갱신하기로 했다면 N과 DF를 함께 다시 계산하고 문서 벡터도 갱신해야 한다.
대수를 배웠다면 로그로 IDF를 나타낼 수 있다
대수 과목을 이수한 학생은 로그를 이용해 IDF를 나타낼 수 있다. 교육과정이 이것을 선택 내용으로 두므로, 이 글의 표와 해보기에는 섞지 않는다. 로그의 뜻을 아는 독자를 위한 비교다.
문서가 아주 많으면 가 너무 커져 계산이 불편하다. 이고 이면 이지만 상용로그를 취하면 5다. 교과서는 손 계산을 위해 밑이 10인 상용로그를 쓰고, 프로그래밍 도구는 대부분 자연로그를 쓴다고 안내한다.

figures/idf_curve.py그림 4에서 두 방식 모두 가 커질수록 IDF가 작아진다. 차이는 끝점에 있다. 이면 이지만 이다. 그래서 로그형에서는 인 단어의 TF-IDF가 0이 되고, 교과 모형에서는 TF와 같은 값이 남는다.
IDF의 순서는 같아도 TF를 곱한 점수의 순서는 달라질 수 있다. C의 바다와 조용하다는 교과 모형에서 3으로 같지만, 상용로그형에서는 와 로 조용하다가 더 크다. 그래서 두 방식의 수치를 한 표에 섞지 않는다.
TF-IDF의 교과 모형의 흔한 오해
- TF-IDF의 붙임표는 뺄셈 기호다. — 식 (1)의 연산은 곱셈이다. A의 숲 점수는 이 아니라 이다.
- 점수가 높으면 글쓴이의 의도까지 알아낸 것이다. — 계산은 정해 둔 어휘와 문서별 빈도에만 의존한다. 오타·비꼼·단어 순서를 구별하는 규칙은 식 (1)에 들어 있지 않다.
TF-IDF를 표 계산으로 확인할 때는 조건을 고정한다
단어별로 TF가 0보다 큰 문서 칸을 세면 DF가 된다. N을 DF로 나눈 행을 만든 뒤 각 TF 행과 성분별로 곱하면 된다. 문서 전체의 횟수를 더한 수와 DF를 혼동하지 않았는지, 빈 문서를 어떻게 포함했는지 기록한다.
계산된 배열은 텍스트 유사도의 입력으로도 쓸 수 있으나 비교하는 모든 문서에 같은 가중치 규칙을 적용해야 한다. 감성 점수와는 목적이 다르므로 사전 기반 감성 분석의 결과를 대신하지 않는다.
직접 해보기
- 문서가 4개이고 한 단어의 문서별 TF가 이다. DF, IDF, 첫 문서의 TF-IDF를 구하자.
- 같은 자료에서 모든 문서에 한 번씩 나오는 단어의 IDF와 각 문서의 점수는 무엇인가?
- 1번에서 첫 문서의 TF만 2에서 7로 바꾸면 DF와 첫 문서의 점수는 어떻게 바뀌는가?
- 1번에 이 단어가 전혀 없는 새 문서 하나를 추가하고 기준 자료를 갱신했다. 첫 문서의 TF를 원래 2로 둘 때 새 IDF와 점수는 무엇인가?
- 세 후기 P, Q, R의 TF가 다음과 같다. 문서마다 TF-IDF가 가장 큰 단어를 구하고, P에서 TF가 가장 큰 단어와 비교하자.
| 구분 | 맛 | 바삭 | 친절 | 배달 |
|---|---|---|---|---|
| TF(P) | 2 | 1 | 0 | 0 |
| TF(Q) | 1 | 0 | 2 | 0 |
| TF(R) | 1 | 0 | 0 | 1 |
답과 풀이
- 양수인 TF가 두 문서에 있으므로 DF는 2다. IDF는 , 첫 점수는 다.
- DF는 4, IDF는 , 각 점수는 이다.
- 여전히 두 문서에 있으므로 DF는 2다. 첫 점수만 가 된다.
- , DF는 2이므로 IDF는 다. 첫 점수는 다. 기준 문서 모음이 바뀌면 기존 문서의 점수도 변할 수 있다.
- DF는 맛 3, 나머지 셋은 1이므로 IDF는 맛 , 나머지는 이다. TF-IDF는 P가 , Q가 , R이 이다. 가장 큰 단어는 P 바삭, Q 친절, R 배달이다. P에서 TF가 가장 큰 단어는 ‘맛’이지만, 세 후기에 모두 있어 IDF가 1이라 ‘바삭’의 3보다 작아진다.
더 읽기
- 교육부, 2022 개정 수학과 교육과정 — 인공지능 수학 [12인수02-02]와 적용 시 고려 사항(대수 이수자의 로그형 IDF). 이 글의 교과 범위와 도구 활동의 근거다.
- 씨마스, 고등학교 인공지능 수학 57–61쪽 — 윤상운 외, 2022 개정판. TF·DF·상대도수·IDF의 네 단계, 문서별 중요 단어 추출, TF-IDF 기준값 안내, 로그형 IDF를 대조했다. 문서·문항·그림의 수치는 이 글에서 새로 구성했다.
- scikit-learn, TfidfTransformer 공식 문서 — 로그·문서 수 보정·벡터 정규화 설정을 설명한다. 도구 기본값은 이 글의 와 다르므로 수치 답을 그대로 대조하지 않는다.
영상 노트
- 00:00 흔한 단어의 점수는 0일까 — 직관과 식 (1)
- 00:40 교과서 네 단계와 , , 구별
- 01:30 그림 1의 TF 합과 문서 빈도 비교
- 02:20 표와 식 (2), 그림 2로 A의 칸 계산
- 03:10 그림 3의 문서별 핵심어, C에서 같아지는 두 점수
- 04:00 식 (3)과 그림 4의 로그형 비교
- 04:50 직접 해보기 5번 풀이
지도에서의 위치
- 2026-11-16 · 에이전트 초안 — 교과 정의·계산·조건·새 연습 작성
- 2026-11-17 · 전수 검수 반영 — 교과서 4단계와 상대도수 행, 문서 빈도와 TF 합의 구별, 문서별 핵심어 고르기, 기준값 질문, 대수 이수자의 로그형, 고정 기준의 새 문서 예와 연습 5문항 보강 (에이전트 수정, 그림 1→4)
- 2026-11-17 · 전수 검수(에이전트 편집·독립 검증) 통과 — 주인 요청으로 완성으로 올림