직관 — 문서마다 있는 물건에만 표시한다
가방에 공책이 두 권 있어도 ‘공책이 있는가’라는 질문에는 한 번만 표시한다. 단어 집합도 문서에 어떤 단어가 있는지를 남긴다. 반복 횟수와 등장 순서는 다른 기록이 있어야 되찾을 수 있다.
집합으로 문서를 나타내면 교집합과 합집합을 이용해 공통 단어를 찾을 수 있다. 다만 어떤 문자열을 한 단어로 셀지 먼저 정해야 한다. 인공지능은 글을 이렇게 만든 수의 배열로 받아 계산하므로, 이 첫 선택이 모델이 보는 자료를 바꾼다.
텍스트의 단어 집합은 처리 규칙을 거친 단어를 중복 없이 모은 것이다
텍스트의 단어 집합은 문장에서 불용어를 제거하고 남은 단어를 중복 없이 모은 집합이다. 교과서는 이것을 붙여 써서 ‘단어집합’이라 부른다. 분석 목적상 제외하기로 정한 단어를 불용어라고 하며, 무엇을 불용어로 볼지는 분석 프로그램과 목적마다 다르다.
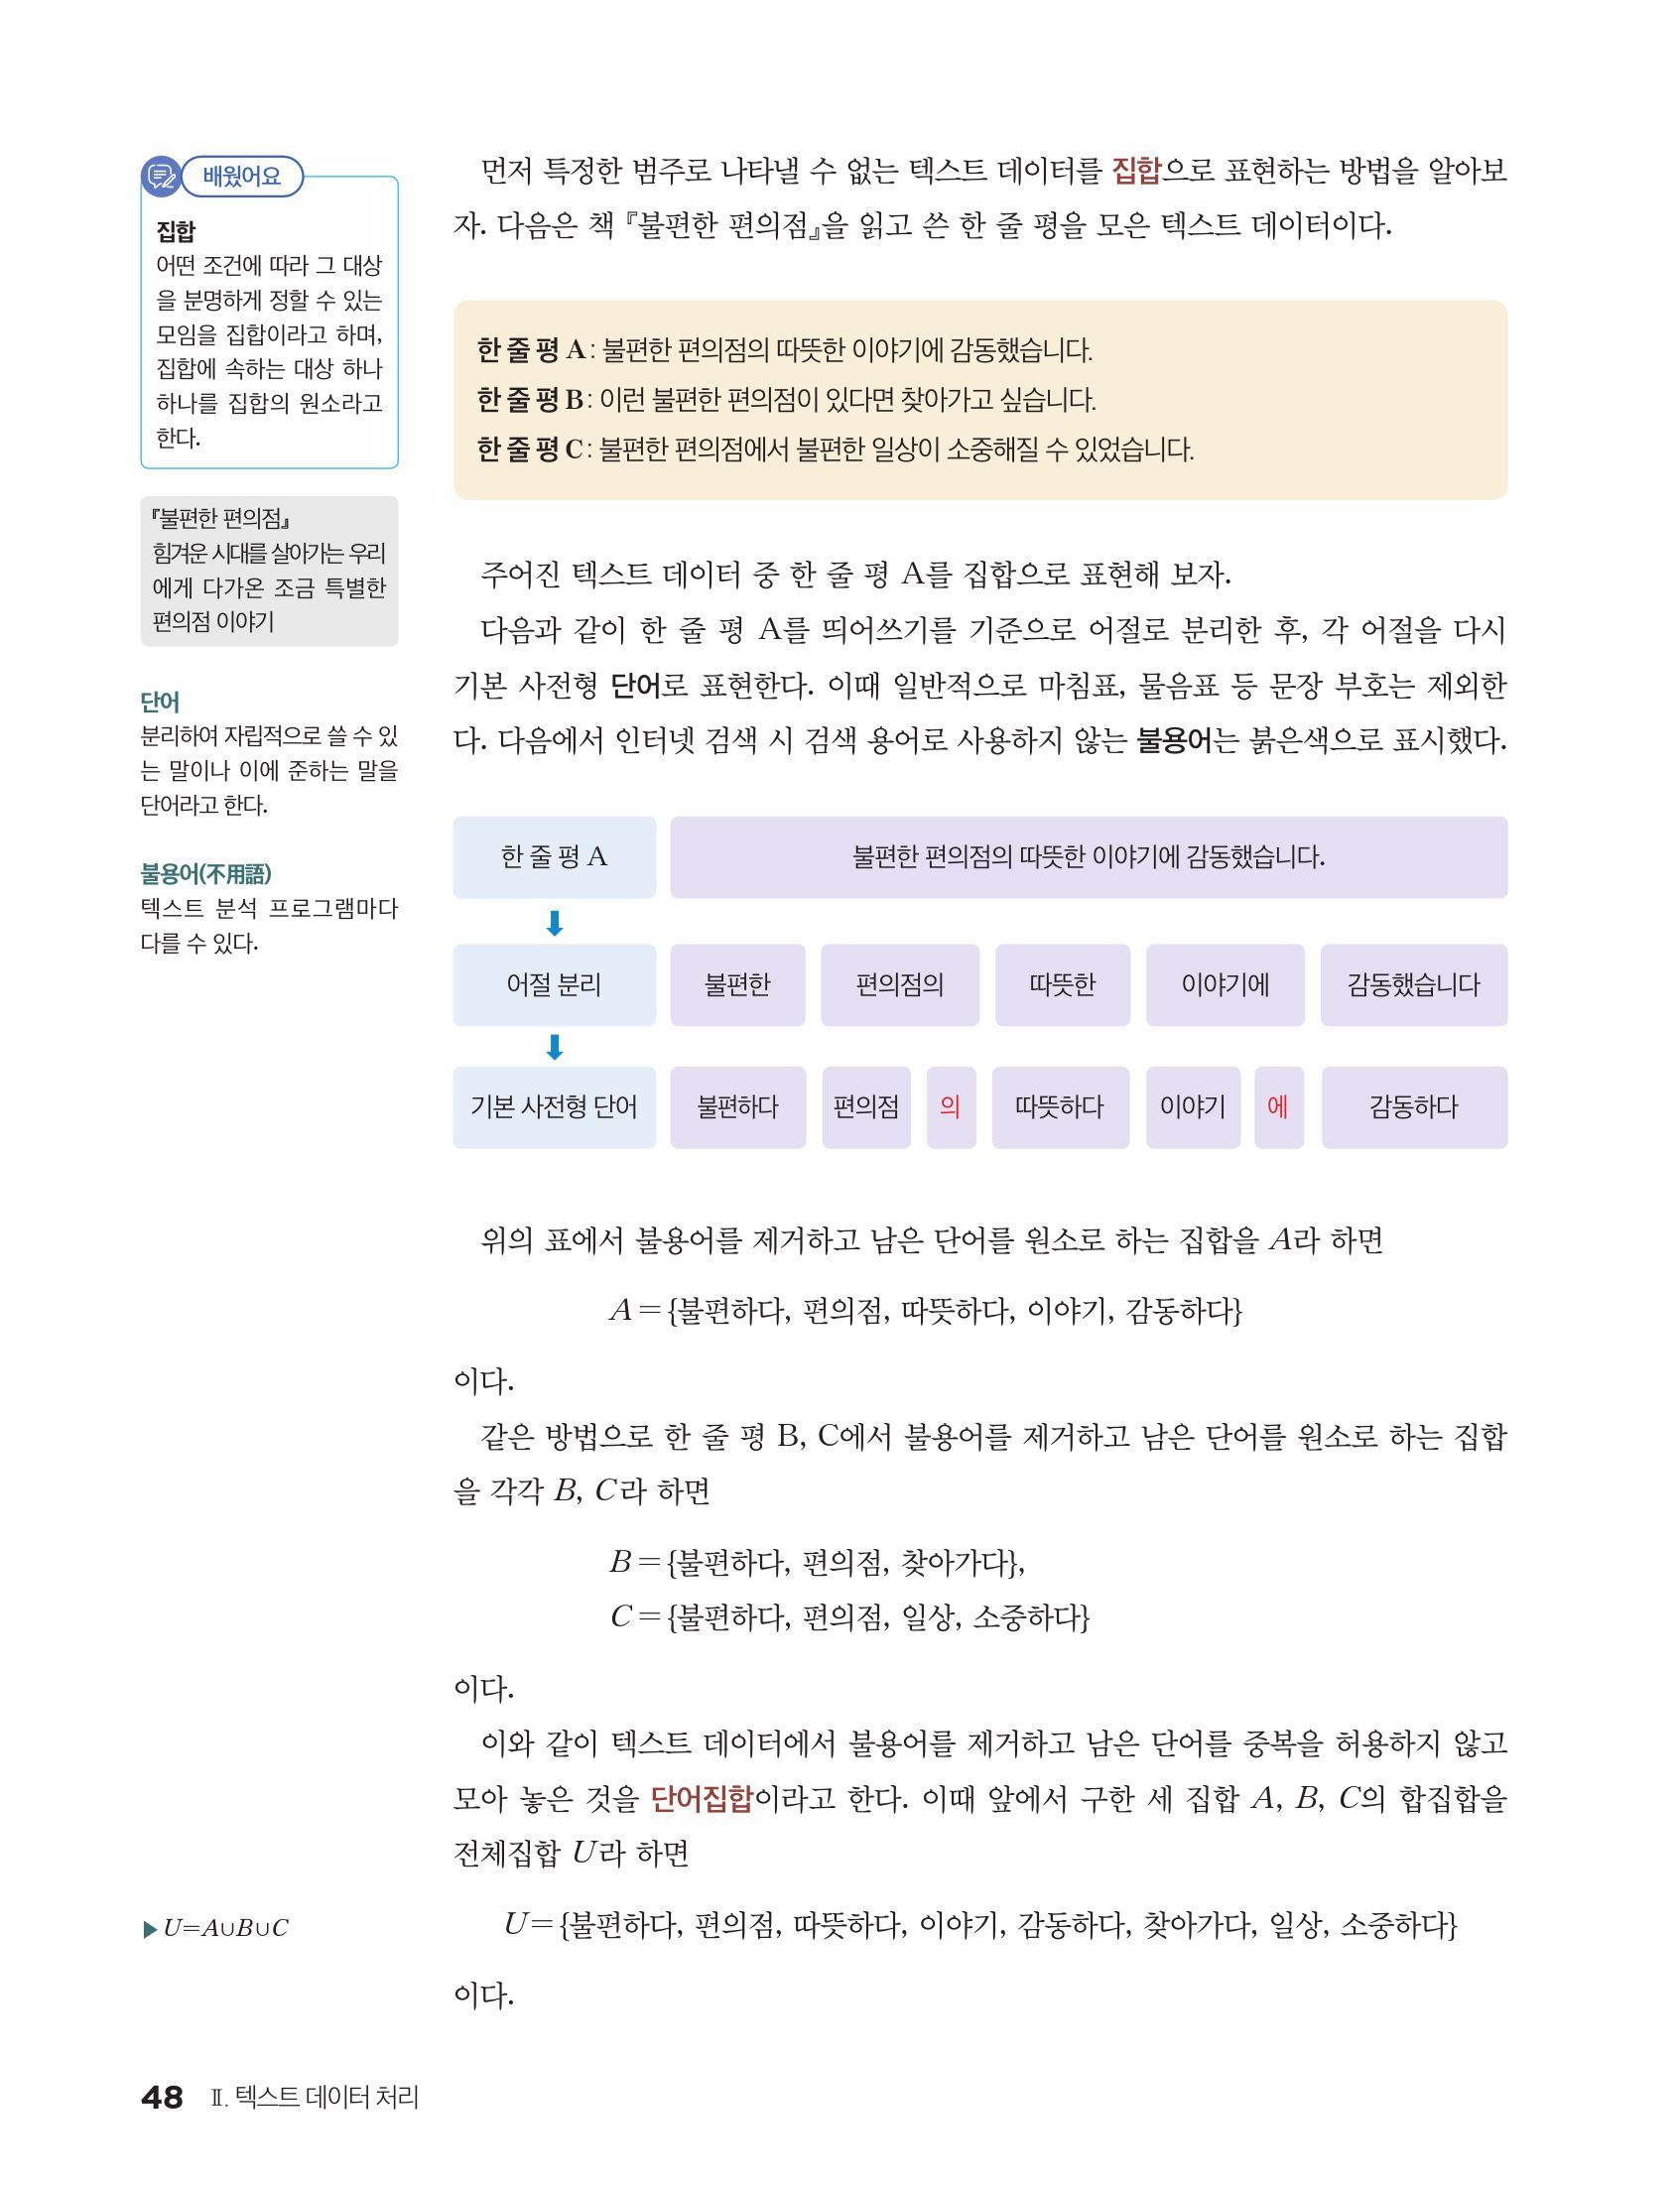
교과서는 문장을 띄어쓰기 기준으로 어절로 나누고, 각 어절을 기본 사전형 단어로 바꾼 뒤 조사 같은 불용어를 지운다. ‘나는 숲에서 산책을 했다.’를 이 순서로 처리하면 다음과 같다. 여기서는 ‘나’와 조사를 불용어로 정했다.
| 단계 | 결과 |
|---|---|
| 어절로 나누기 | 나는, 숲에서, 산책을, 했다 |
| 기본형과 조사로 나누기 | 나, 는, 숲, 에서, 산책, 을, 하다 |
| 불용어 지우기 | 숲, 산책, 하다 |
기본형으로 바꾸지 않고 띄어쓰기로만 나누면 같은 단어가 다른 원소가 된다. ‘숲에서 걷다.’와 ‘숲이 좋다.’를 공백으로만 나누면 {숲에서, 걷다}와 {숲이, 좋다}여서 공통 원소가 없다. 기본형으로 바꾸고 조사를 지우면 {숲, 걷다}와 {숲, 좋다}가 되어 교집합이 {숲}이다.
문장을 분석 단위로 나누는 일을 토큰화라고 하고, 나뉜 단위를 토큰이라고 한다. 아래 세 문서는 실제 이용자의 후기가 아니라 이 처리를 이미 마친 꼴로 직접 만든 학습용 문서다. 그래서 ① 마침표를 지우고 ② 공백으로 나누고 ③ ‘나는’, ‘그리고’를 지우는 것만으로 같은 결과가 나온다.
| 문서 | 원문 |
|---|---|
| A | 나는 숲 산책 숲 좋다. |
| B | 나는 바다 산책 좋다. |
| C | 바다 바다 그리고 조용하다. |
| 문서 | 처리 후 순서 있는 목록 | 단어 집합 |
|---|---|---|
| A | 숲, 산책, 숲, 좋다 | {숲, 산책, 좋다} |
| B | 바다, 산책, 좋다 | {바다, 산책, 좋다} |
| C | 바다, 바다, 조용하다 | {바다, 조용하다} |
세 집합을 각각 라 하면 세 집합의 합집합은 다음과 같다. 교과서는 이것을 전체집합 라 부른다.
집합은 원소의 순서를 구별하지 않는다. 수로 바꾸려면 이 집합과 별도로 순서 있는 어휘 목록을 고정해야 한다. 이 글에서는 로 정한다.
| 기호 | 이름 | 원어 | 뜻 |
|---|---|---|---|
| 단어 집합 | word set | 문서 A의 처리 후 단어를 중복 없이 모은 집합 | |
| 원소의 개수 | number of elements | 집합 에 있는 서로 다른 단어의 수 | |
| 어휘 집합(전체집합) | vocabulary | 비교할 세 문서에 있는 단어 전체 | |
| 어휘 목록의 단어 | vocabulary entry | 고정한 목록의 번째 단어 | |
| 존재 벡터 | binary presence vector | 문서 A의 단어 존재 여부를 순서대로 적은 수의 배열 | |
| 성분 | component | 문서 A에 가 있으면 1, 없으면 0 |
그림 1은 문서 A가 집합과 벡터로 바뀌는 과정이다. 목록에는 토큰이 4개지만 ‘숲’()이 두 번 나와 두 화살표가 한 원소로 모인다. 그래서 이다. 반복된 단어는 집합 안에서 원소 하나로 합쳐진다.

figures/list_to_set.py단어 집합의 연산으로 공통 단어와 한 문서에만 있는 단어를 찾는다
교집합을 구하면 두 문서의 공통 단어가, 차집합을 구하면 한 문서에만 있는 단어가 나온다. 그림 2에서 이고 이다.

figures/word_set_venn.pyA와 C는 공통 단어가 없으므로 이다. 공통 원소가 없는 두 집합을 서로소라고 한다. B와 C는 이고, 는 B에만 있고 A에는 없는 단어다.
합집합 는 숲·바다·산책·좋다로 원소가 4개다. 세 집합을 모두 합하면 식 (1)의 가 된다. 공통 원소 수를 합집합의 원소 수와 견주는 생각은 텍스트 유사도의 자카드 유사도로 이어진다.
텍스트의 단어 집합을 왜 같은 순서의 0과 1로 바꿀까?
같은 순서의 0과 1로 바꾸면 A, B, C가 길이 5인 수 배열 셋이 되어 자리별로 비교할 수 있다. 어휘 목록의 각 단어가 문서에 있으면 1, 없으면 0을 놓는다.
여러 개의 수를 순서대로 나열한 것을 이 단원에서는 벡터라고 한다. 괄호 안의 각 수를 성분, 성분의 개수를 차원이라고 한다. 화살표의 방향이나 물리적인 힘을 먼저 배울 필요는 없다.
교과서는 벡터를 처럼 화살표를 얹어 쓴다. 이 페이지의 굵은 글자 와 같은 뜻이다. 식 (2)의 세 벡터는 모두 5차원이다. A의 첫째 성분 이 1인 것은 첫째 단어 ‘숲’이 A에 있다는 뜻이며, ‘숲’이 두 번 나와도 1이다.

figures/presence_table.py그림 3의 한 열은 한 단어를 뜻한다. 그래서 집합 연산을 벡터의 자리에서 읽을 수 있다. 존재 벡터의 성분을 모두 더하면 1의 개수, 곧 어휘 안의 원소 수다. A는 이다.
두 벡터에서 같은 자리가 모두 1인 성분만 1로 두면 교집합의 존재 벡터가 된다. A와 B에서는 셋째와 넷째 자리만 남는다.
식 (3)의 결과는 의 존재 벡터다. 하나라도 1인 자리를 1로 두면 합집합 이 되고, 그 성분의 합 4가 의 원소 수다. 교과서는 단어의 등장 여부를 0 또는 1로 나타내는 이 방식을 ‘단어집합 모형’이라고 부른다.
원-핫 벡터는 단어 하나를 나타내는 벡터다
원-핫 벡터는 어휘의 원소 수를 차원으로 하고, 나타낼 단어의 자리에만 1, 나머지 자리에 0을 놓은 벡터다. 의 원-핫 벡터를 라 쓰면 ‘숲’은 이다.
차원이 같은 두 벡터의 덧셈은 같은 자리의 성분끼리 더하는 것이다. 문서 A의 서로 다른 단어 셋의 원-핫 벡터를 더하면 존재 벡터가 된다.

figures/one_hot_sum.py그림 4에서 각 원-핫 벡터는 1을 정확히 하나 갖는다. 반복된 ‘숲’까지 토큰 네 개의 원-핫 벡터를 더하면 으로 횟수가 남는다. 이것이 다음 글의 단어가방 모형이다.
원-핫 벡터는 단어 사이의 관계를 담지 않는다. 서로 다른 두 단어를 고르면 원-핫 벡터의 1은 같은 자리에 오지 않는다. 그래서 뜻이 가까운 단어끼리도 서로 무관한 것처럼 표현된다. 어휘가 커지면 벡터의 차원도 그만큼 커진다.
텍스트의 단어 집합을 비교하려면 어휘 순서를 고정해야 한다
같은 문서라도 어휘 순서가 다르면 다른 벡터가 된다. 순서를 문서마다 다르게 쓰면 다른 문서가 같은 벡터처럼 보일 수도 있다.
그림 5처럼 A만 ‘바다, 숲, 산책, 좋다, 조용하다’ 순서로 잘못 쓰면 이 된다. 이 배열은 원래 순서로 쓴 와 숫자가 같다. 하지만 첫째 자리가 뜻하는 단어가 달라 A와 B의 단어 집합은 다르다.

figures/order_mismatch.py두 벡터는 차원이 같고 대응하는 성분이 모두 같을 때 같다고 한다. 어휘가 비교할 문서의 단어를 모두 담고 모든 문서에 같은 어휘 순서를 쓰면, 각 자리가 한 단어의 존재 여부이므로 존재 벡터가 같은 것과 단어 집합이 같은 것은 같은 뜻이다. 와 는 첫째 성분이 1과 0으로 달라 같은 벡터가 아니다.
텍스트의 단어 집합은 반복을 하나로 모으므로 존재 여부만 남긴다. 문서끼리 0과 1을 비교하려면 처리 규칙과 어휘 순서도 같아야 한다.
텍스트의 단어 집합에서 불용어는 항상 지워도 될까?
아니다. ‘안’을 불용어로 정해 지우면 ‘좋다’와 ‘안 좋다’가 같은 집합 {좋다}가 되어 반대 평가를 구별하지 못한다. 불용어는 모든 작업에 통하는 정답 목록이 아니라 분석 목적에 맞춰 검토하는 선택이다.
텍스트의 단어 집합이 비면 벡터를 만들 수 없을까?
고정된 어휘 목록이 있으면 빈 문서는 모든 성분이 0인 벡터로 나타낼 수 있다. 이 글의 다섯 단어 목록에서는 이다. 다만 뒤에서 이 벡터로 나눗셈을 하는 유사도는 정의되지 않을 수 있으므로 빈 문서 여부를 따로 기록한다.
텍스트의 단어 집합에 처음 보는 단어가 들어오면 어떻게 할까?
이 글에서는 기존 어휘에 없는 단어를 비교용 벡터에서 제외하고, 제외한 단어 목록을 별도로 남긴다. ‘숲 별빛’은 이고 ‘별빛’이 제외되었다고 기록한다. 어휘를 확장하는 정책도 가능하지만 그때는 모든 문서를 새 어휘 순서로 다시 표현해야 한다.
텍스트의 단어 집합의 흔한 오해
- 집합의 원소 수는 문서의 전체 단어 수다. — A는 처리 후 토큰이 4개지만 이다. 집합으로 바꾸며 반복 정보가 사라졌다.
- 존재 벡터의 차원은 그 문서의 단어 수다. — 차원은 어휘 목록의 크기 5로 모든 문서가 같다. C는 서로 다른 단어가 2개지만 도 5차원이다.
- 숫자로 바꾸면 문장의 뜻도 그대로 보존된다. — ‘고양이가 개를 쫓다’와 ‘개가 고양이를 쫓다’는 기본형으로 바꾸고 조사를 지우면 같은 집합 {고양이, 개, 쫓다}가 된다. 쫓는 쪽이 다르다는 정보는 존재 벡터만으로 되살릴 수 없다.
텍스트의 단어 집합은 다음 계산의 입력을 정한다
단어가방 모형은 같은 어휘 목록에 등장 횟수를 기록한다. 텍스트 유사도는 집합의 겹침이나 수 배열을 비교한다. 어느 방법이든 원문을 따로 보관해야 잘못된 분리나 삭제가 결과를 바꿨는지 되돌아볼 수 있다.
직접 해보기
다음 문항도 이 글의 처리 규칙과 어휘 순서 숲·바다·산책·좋다·조용하다를 쓴다.
- ‘나는 바다 숲 바다.’의 처리 후 목록, 단어 집합, 존재 벡터를 구하자.
- 문서 D의 단어 집합이 {바다, 산책, 조용하다}이다. D의 존재 벡터가 과 같을 때 , 와 벡터의 차원을 구하자.
- 어휘 목록만 ‘좋다, 숲, 바다, 산책, 조용하다’로 바꿀 때 문서 C의 벡터는 무엇인가?
- 식 (2)의 와 에서 교집합과 합집합의 존재 벡터를 구하고, 각각 어떤 단어 집합인지 말하자.
- ‘바다 별빛 별빛’을 기존 어휘로 나타내고, 벡터에서 없어진 정보를 설명하자.
답과 풀이
- 목록은 ‘바다, 숲, 바다’, 집합은 {바다, 숲}이다. 원래 어휘 순서로는 이다. 두 번째 ‘바다’는 집합에 새 원소를 더하지 않는다.
- D에는 바다·산책·조용하다가 있으므로 존재 벡터는 이다. 대응하는 성분이 같아야 하므로 , 에서 다. 차원은 어휘 크기와 같은 5다.
- C에는 ‘바다’, ‘조용하다’가 있으므로 이다. 단어 집합은 같고 성분의 자리만 달라졌다.
- 둘 다 1인 자리는 둘째뿐이므로 교집합은 , 곧 {바다}다. 하나라도 1인 자리를 모으면 이고, {바다, 산책, 좋다, 조용하다}로 원소가 4개다.
- 이다. 제외 목록에는 ‘별빛’이 두 번 남는다. 벡터만 보면 별빛의 존재도, 두 번 반복했다는 사실도 알 수 없다.
더 읽기
- 교육부, 2022 개정 수학과 교육과정 — 인공지능 수학 [12인수02-01]. 이 글의 교과 범위와 도구 활동의 근거다.
- 씨마스, 고등학교 인공지능 수학 48–51쪽 — 윤상운 외, 2022 개정판. 어절·기본형·불용어 처리, 단어집합, 벡터의 성분·차원, 원-핫 벡터를 대조했다. 문서·문항·그림의 수치는 이 글에서 새로 구성했다.
영상 노트
- 00:00 반복된 단어는 어디로 갈까 — 그림 1의 목록과 집합
- 00:40 교과서식 처리: 어절, 기본형, 불용어
- 01:30 그림 2의 벤 다이어그램으로 교집합·차집합 읽기
- 02:20 식 (2)의 존재 벡터와 성분·차원, 식 (3)의 교집합 읽기
- 03:10 식 (4)와 그림 4의 원-핫 벡터 합
- 04:00 그림 5의 순서 반례와 벡터의 상등
- 04:40 직접 해보기 2번 풀이
지도에서의 위치
- 2026-11-16 · 에이전트 초안 — 교과 정의·계산·조건·새 연습 작성
- 2026-11-17 · 전수 검수 반영 — 교과서식 기본형·조사 처리, 집합 연산, 벡터의 성분·차원·상등(어휘가 문서 단어를 모두 담을 때로 한정), 원-핫 벡터, 순서 반례와 연습 5문항 보강 (에이전트 수정, 그림 1→5)
- 2026-11-17 · 전수 검수(에이전트 편집·독립 검증) 통과 — 주인 요청으로 완성으로 올림