직관 — 단어를 종류별로 분류해 개수를 센다
같은 종류의 구슬을 모으면 색별 개수는 알 수 있지만 원래 꿰었던 순서는 모른다. 단어가방도 단어별 개수를 남긴다. 순서를 버리는 덕분에 계산이 단순해지는 대신 문장의 일부 의미를 잃는다.
텍스트의 단어 집합은 단어가 있는지 기록했다. 여기서는 같은 가상 문서와 처리 규칙을 받아 ‘몇 번 있는가’를 기록한다. 단어가방 모형은 영어로 bag-of-words, 줄여서 BoW라 하고 ‘단어 주머니’라고도 부른다. 인공지능이 문서를 분류하거나 비슷한 문서를 찾을 때 쓰는 가장 기본적인 수 표현 가운데 하나다.
단어가방 모형은 단어별 빈도수를 성분으로 갖는다
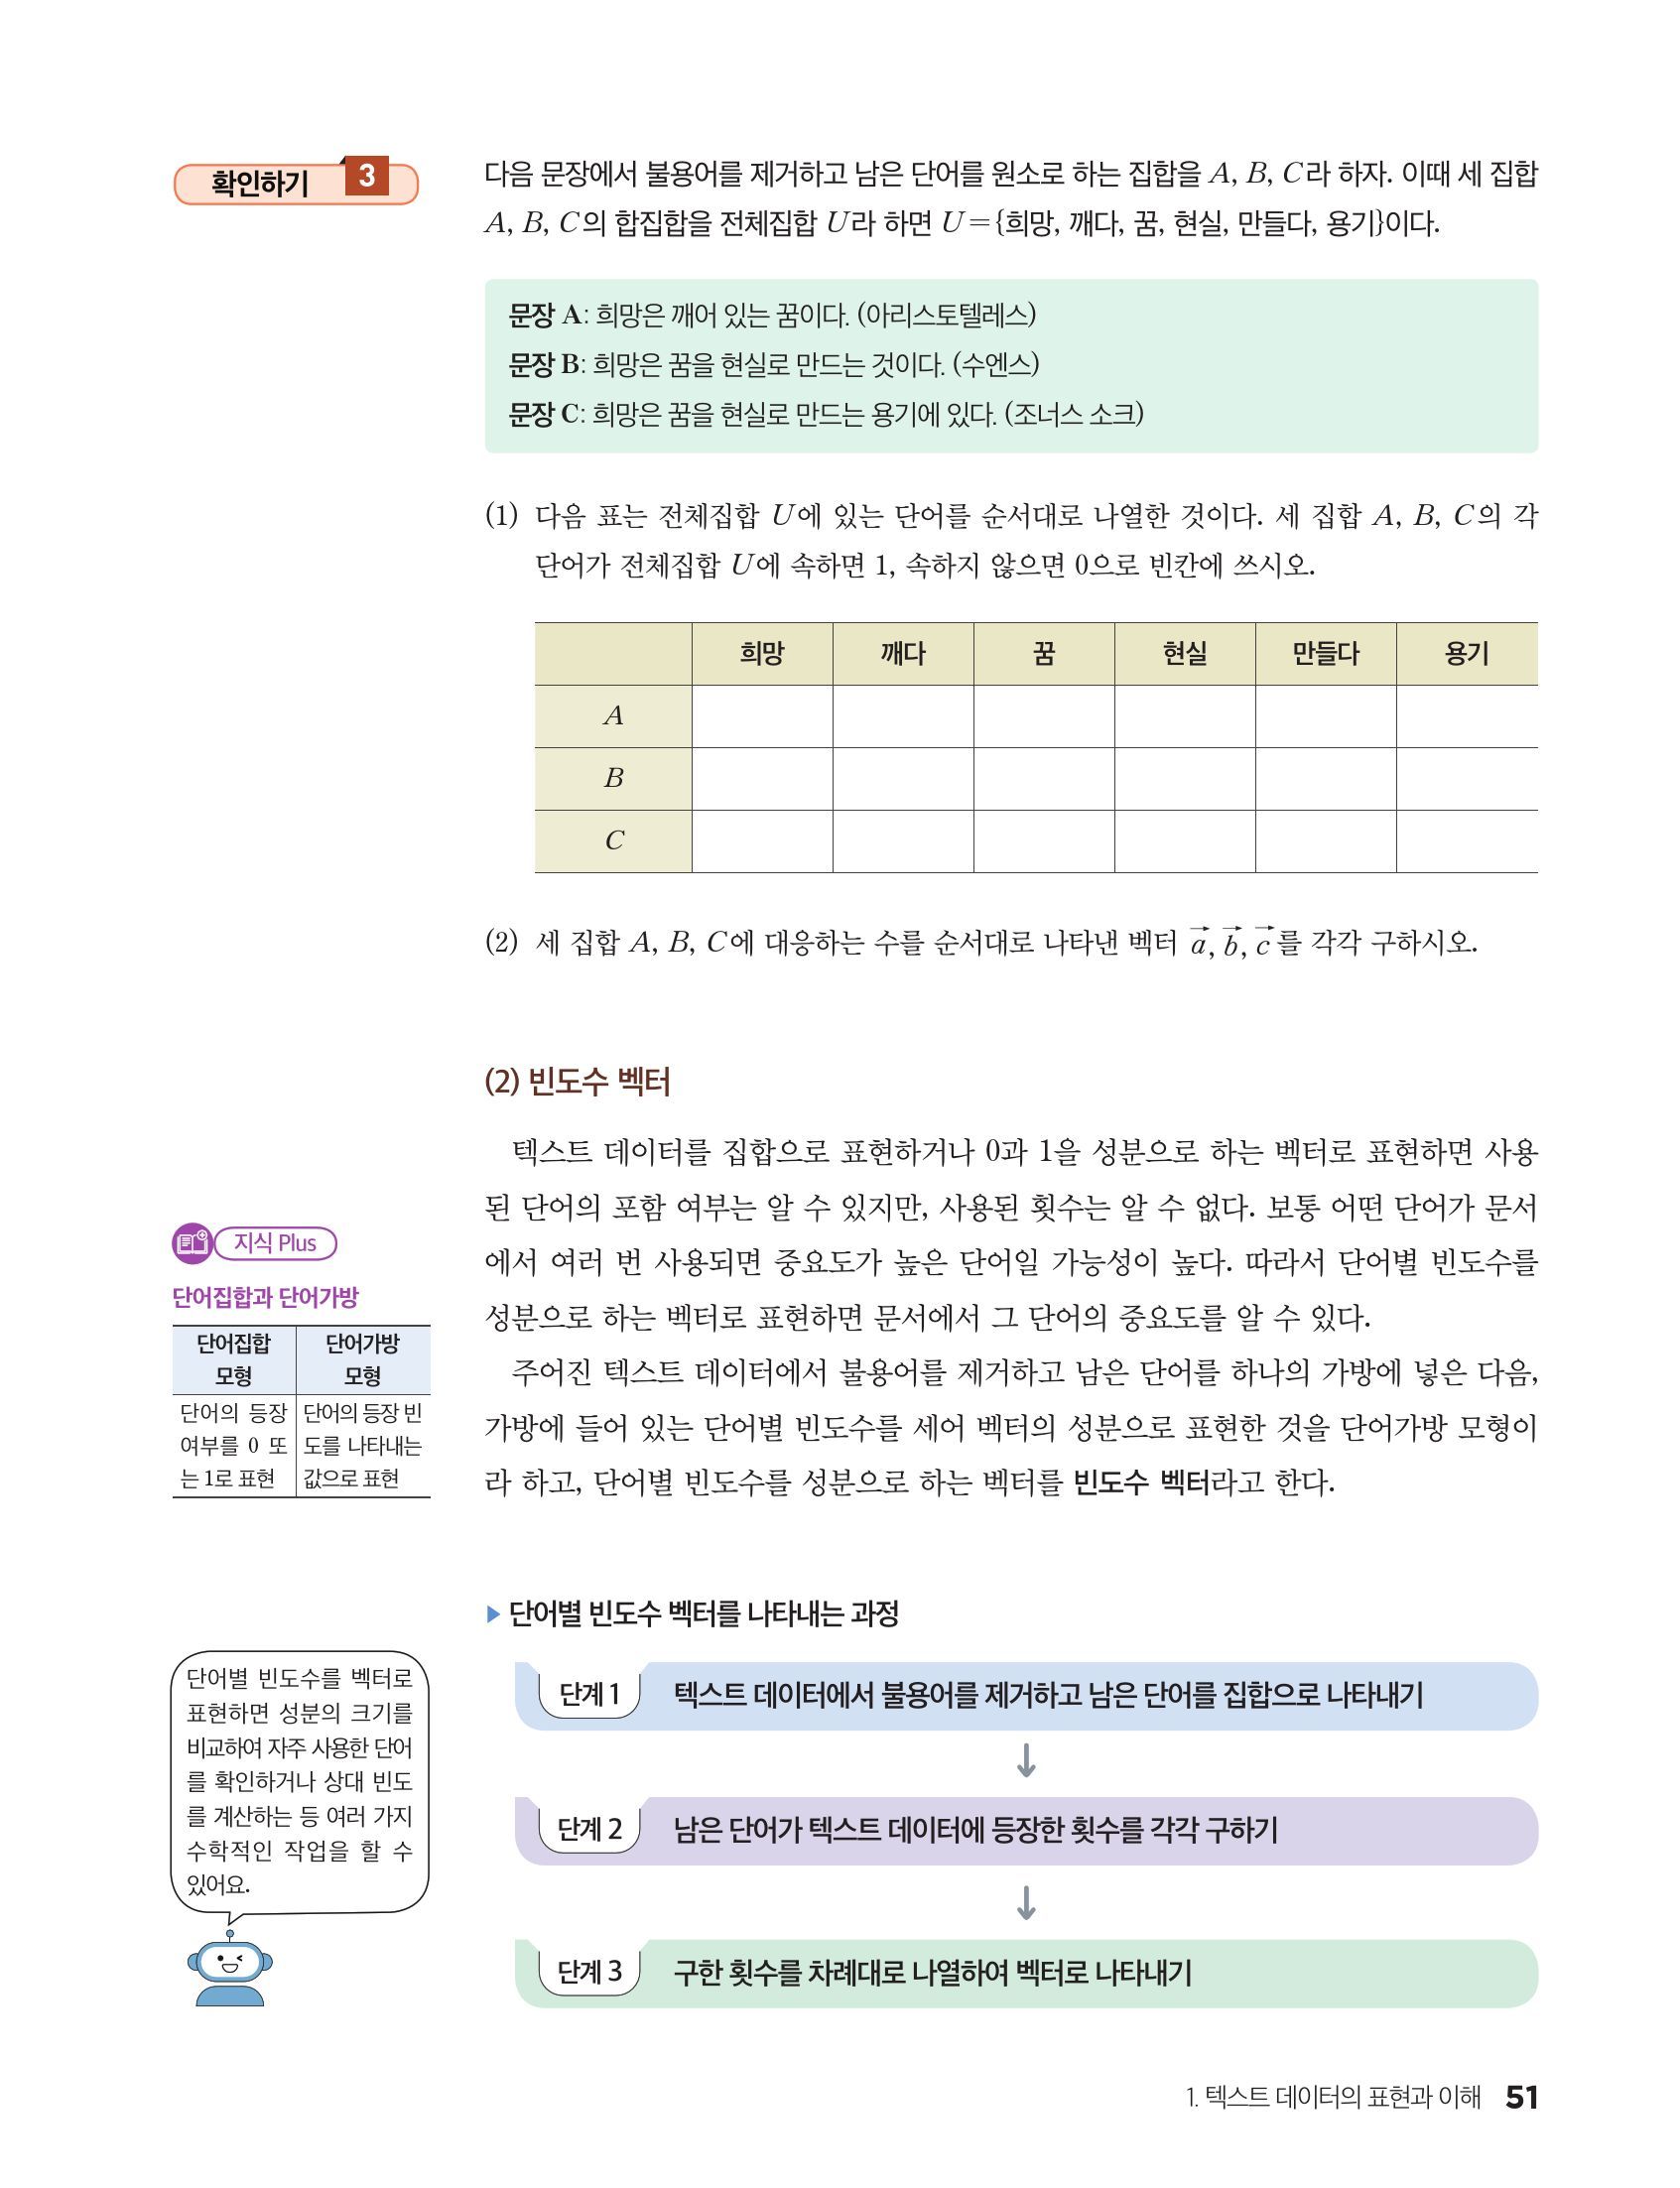
단어가방 모형은 불용어를 제거하고 남은 단어를 한 가방에 넣고, 단어별 빈도수를 세어 벡터의 성분으로 나타낸 것이다. 이렇게 만든 벡터를 빈도수 벡터라고 한다. 교과서는 다음 세 단계로 만든다.
- 불용어를 제거하고 남은 단어를 집합으로 나타낸다.
- 남은 단어가 문서에 나온 횟수를 각각 구한다.
- 구한 횟수를 정해 둔 어휘 순서대로 나열한다.
어휘 순서를 로 고정하자. 마침표를 지우고 공백으로 나누며 ‘나는’, ‘그리고’는 제외한다. 이 규칙으로 남은 목록은 다음과 같다.
| 문서 | 처리 후 목록 |
|---|---|
| A | 숲, 산책, 숲, 좋다 |
| B | 바다, 산책, 좋다 |
| C | 바다, 바다, 조용하다 |
문서 에서 단어 가 등장한 횟수를 라 한다. 이 글의 TF는 정규화하지 않은 횟수다. 각 횟수를 같은 순서로 나열한 것이 빈도수 벡터다.
| 기호 | 이름 | 원어 | 뜻 |
|---|---|---|---|
| 어휘 목록의 단어 | vocabulary entry | 고정한 목록의 번째 단어 | |
| 문서 | document | 여기서는 A, B, C 중 하나 | |
| 단어 빈도수 | term frequency | 문서 에 가 나온 횟수 | |
| 빈도수 벡터 | count vector | 어휘 순서대로 적은 단어별 횟수 | |
| 집계한 길이 | counted length | 어휘 목록에 포함되어 실제 집계한 토큰 수 | |
| 상대 빈도 벡터 | relative frequency vector | 일 때 각 횟수를 로 나눈 배열 |
그림 1은 A의 토큰 네 개를 단어별 칸에 넣는 모습이다. 두 ‘숲’이 같은 칸에 쌓여 첫째 성분이 2가 되고, 아무것도 들어가지 않은 칸은 0이다.

figures/bag_tally.py단어가방 모형의 표는 한 칸씩 어떻게 채울까?
문서마다 어휘의 각 단어가 몇 번 나왔는지 세어 한 줄씩 적는다. A의 목록에는 ‘숲’ 두 개, ‘산책’ 한 개, ‘좋다’ 한 개가 있고 나머지 단어는 없으므로 0이다. B와 C에도 같은 절차를 적용하면 다음과 같다.

figures/count_table.py그림 2처럼 문서를 행, 단어를 열로 놓은 표를 문서-단어 행렬(document-term matrix, DTM)이라고도 부른다. 집계 대상 토큰 하나는 정확히 한 단어의 칸에 1을 더한다. 따라서 한 행의 성분을 더하면 집계한 토큰 수가 된다. A에서는 이다.
공백·마침표나 제거한 불용어는 이 합에 들어가지 않는다. 어휘 밖의 단어도 제외하는 정책이면 원문 전체의 단어 수와 다를 수 있다.
단어가방 모형은 단어집합 모형보다 무엇을 더 남길까?
단어가방 모형은 단어집합 모형이 버린 반복 횟수를 남긴다. 단어집합 모형은 단어가 있으면 1, 없으면 0만 적기 때문이다.
| 표현 | 성분의 뜻 | A의 벡터 | 성분의 합 |
|---|---|---|---|
| 단어집합 모형 | 있으면 1, 없으면 0 | 3 (서로 다른 단어 수) | |
| 단어가방 모형 | 나온 횟수 | 4 (집계한 토큰 수) |
빈도수 벡터에서 0이 아닌 성분을 모두 1로 바꾸면 존재 벡터가 나온다. 거꾸로 존재 벡터에서는 횟수를 되찾을 수 없다. ‘숲 숲 산책’과 ‘숲 산책’은 존재 벡터가 같지만 ‘숲’의 빈도수는 각각 2와 1이다.
단어가방 모형은 왜 어순을 잃을까?
단어가방 모형은 각 단어가 몇 번 나왔는지만 세므로, 같은 토큰을 다른 순서로 늘어놓아도 같은 벡터가 된다. 그림 3에서 A의 목록과 순서만 바꾼 목록 A′는 모두 이다.

figures/same_bag_orders.py순서가 뜻을 바꾸는 문장에서는 이것이 정보 손실이 된다. ‘민수 영희 좋아하다’와 ‘영희 민수 좋아하다’는 세 토큰의 횟수가 모두 1이라 같은 벡터다. 누가 누구를 좋아하는지는 이 배열만으로 구별하지 못한다.
빈도수 벡터를 더하면 문서 모음의 주제어를 찾을 수 있다
여러 문서의 빈도수 벡터를 같은 자리끼리 더하면 문서 모음 전체의 단어별 빈도가 된다. 성분이 가장 큰 단어가 모음 전체에서 가장 자주 쓰인 단어다.

figures/corpus_total_stack.py그림 4에서 ‘바다’는 B에서 1번, C에서 2번 나와 합이 3이다. 의 성분 합 10은 세 문서의 집계 토큰 수 과 같다. 교과서는 이렇게 빈도수가 가장 큰 단어를 그 문서 모음의 주제어로 읽는다.
문서 하나에서도 같은 방법을 쓴다. A에서는 ‘숲’이 2, C에서는 ‘바다’가 2로 가장 크다. B는 바다·산책·좋다가 모두 1이라 횟수만으로는 하나를 고를 수 없다.
교과서는 어휘를 합계 빈도가 큰 단어부터 늘어놓는 것이 보통이라고 안내한다. 이 자료로는 바다(3), 숲·산책·좋다(2), 조용하다(1) 순이다. 어떤 순서를 고르든 모든 문서에 같은 순서를 쓰면 된다.
단어가방 모형에서 긴 문서는 항상 더 중요한가?
그렇지 않다. 긴 문서에는 같은 단어가 단순히 더 자주 나올 수 있다. 길이의 영향을 줄여 비중을 보려면 집계한 길이가 양수일 때 각 성분을 그 길이로 나눈다.
A의 ‘숲’ 비중은 이고, C의 ‘바다’ 비중은 이다. 같은 횟수 2라도 비중은 다르다. 각 성분을 로 나누었으니 상대 빈도를 더하면 이다. 이 글에서는 식 (1)의 TF와 식 (4)의 상대 빈도를 서로 다른 이름으로 쓴다.
문서 A를 그대로 두 번 이어 쓴 문서를 AA라 하자. 그림 5에서 AA의 횟수는 으로 A의 두 배이고 집계 길이는 8이다. 길이로 나눈 비율은 A와 똑같다.

figures/length_normalization.py단어가방 모형은 반복 횟수를 보존하고 단어 순서를 버린다. 같은 빈도수 벡터라도 문장의 뜻은 다를 수 있으며, 횟수와 길이로 나눈 비율은 구별해야 한다.
단어가방 모형에서 빈 문서도 길이로 나누면 될까?
아니다. 집계 대상이 없는 문서는 횟수가 모두 0이고 이므로 상대 빈도를 계산할 수 없다. 계산에서 제외하거나 별도의 빈 문서 표시를 두며, 0으로 나눈 결과를 정상적인 빈도 비율로 쓰지 않는다.
단어가방 모형과 원-핫 벡터는 어떤 관계일까?
단어가방 모형의 빈도수 벡터는 토큰마다 그 단어의 원-핫 벡터를 더한 것이다. A는 ‘숲’, ‘산책’, ‘숲’, ‘좋다’의 원-핫 벡터를 더해 이 된다. 서로 다른 단어만 한 번씩 더하면 존재 벡터 이다.
단어가방 모형의 단점은 무엇일까?
단어가방 모형은 어순을 잃고, 어휘가 커질수록 0이 대부분인 긴 벡터가 된다. 이 글의 작은 표도 15칸 가운데 7칸이 0이다. 실제 문서 모음은 어휘가 훨씬 많아 대부분의 칸이 0인 희소 벡터가 되고, 뜻이 비슷한 단어도 서로 다른 칸에 따로 놓인다.
단어가방 모형의 흔한 오해
- 빈도수 벡터의 성분 합은 서로 다른 단어 수다. — A의 성분 합은 4이고 서로 다른 단어는 3개다. 서로 다른 단어 수는 존재 벡터의 성분 합이다.
- 많이 나온 단어는 반드시 주제를 정확히 나타낸다. — 같은 인사말을 반복하거나 주제와 무관한 내용을 복사해도 빈도수는 커진다. 횟수는 선택한 중요도 지표이지 문맥 이해의 보증이 아니다.
- 한 문서에서 세 번 나오면 세 문서에서 나온 것이다. — 횟수는 문서 하나의 반복을 센다. 여러 문서에 얼마나 퍼졌는지는 TF-IDF의 문서 빈도수로 따로 계산한다.
단어가방 모형은 표 계산으로도 확인할 수 있다
스프레드시트의 한 열(예: B2:B5)에 문서 A의 처리 후 토큰 네 개를 적는다. 옆 칸에 =COUNTIF(B2:B5,"숲")처럼 어휘마다 개수를 세면 2, 0, 1, 1, 0이 나온다. 합이 4인지 확인한 뒤, 다른 문서도 같은 열 순서로 채운다.
열 순서를 유지해야 텍스트 유사도에서 대응하는 성분을 비교할 수 있다. 빈도수에 단어별 감성 점수를 곱해 더하면 사전 기반 감성 분석이 된다. 흔한 단어의 비중을 낮추려면 TF-IDF로 넘어간다.
직접 해보기
어휘 순서는 이 글의 다섯 단어 순서를 유지한다.
- ‘바다 숲 바다 좋다 좋다’의 빈도수 벡터와 집계 길이를 구하자.
- 1번의 상대 빈도 벡터를 구하자.
- 1번 문서를 A, B, C와 함께 모아 문서가 넷인 모음을 만들었다. 네 문서의 합계 벡터와 가장 자주 쓰인 단어를 구하자. 1번 문서 하나에서 가장 많이 나온 단어는 무엇인가?
- 어떤 문서의 빈도수 벡터가 이다. 존재 벡터, 서로 다른 단어 수, 집계 길이를 구하자. 이 벡터로 원래 문장을 하나로 정할 수 있는가?
- ‘별빛 별빛’을 어휘 밖 단어로 제외하면 어떤 벡터가 되는가? 상대 빈도를 구할 수 있는가?
답과 풀이
- , 길이는 다.
- 각 성분을 5로 나누어 이다. 합은 1이다.
- 식 (3)에 더하면 이고, ‘바다’가 5로 가장 크다. 1번 문서 하나에서는 바다와 좋다가 2로 같아 하나로 정할 수 없다.
- 0이 아닌 성분을 1로 바꾸면 이고, 서로 다른 단어는 바다·좋다·조용하다 3개다. 집계 길이는 다. ‘바다 바다 바다 좋다 조용하다’와 ‘조용하다 바다 좋다 바다 바다’가 모두 이 벡터이므로 원래 문장을 하나로 정할 수 없다.
- 이며 집계 길이는 0이다. 상대 빈도는 정의되지 않는다. 원문에는 토큰이 있어도 고정 어휘에 대응하는 정보는 없다는 뜻이다.
더 읽기
- 교육부, 2022 개정 수학과 교육과정 — 인공지능 수학 [12인수02-02]. 이 글의 교과 범위와 도구 활동의 근거다.
- 씨마스, 고등학교 인공지능 수학 51–53쪽 — 윤상운 외, 2022 개정판. 빈도수 벡터의 3단계, 단어집합 모형과 단어가방 모형의 비교, 합계 벡터와 주제어를 대조했다. 문서·문항·그림의 수치는 이 글에서 새로 구성했다.
- scikit-learn, Text feature extraction — 공식 사용자 안내서 8.2.3.1 'The Bag of Words representation'. 단어의 상대 위치를 무시하고 등장 횟수로 문서를 나타내는 도구의 기본 동작을 확인할 수 있다.
영상 노트
- 00:00 횟수가 같으면 뜻도 같을까 — 그림 1의 가방에 토큰 넣기
- 00:40 교과서 3단계와 식 (1)의 TF
- 01:20 식 (2)와 그림 2의 문서-단어 표, 행의 합 확인
- 02:00 단어집합 모형과 단어가방 모형 비교표
- 02:40 그림 3의 어순 반례와 민수·영희 문장
- 03:20 식 (3)과 그림 4의 합계 벡터, 주제어
- 04:10 식 (4)와 그림 5의 상대 빈도
- 04:50 직접 해보기 3·4번 풀이
지도에서의 위치
- 2026-11-16 · 에이전트 초안 — 교과 정의·계산·조건·새 연습 작성
- 2026-11-17 · 전수 검수 반영 — 교과서 3단계 절차, 단어집합 모형과의 비교, 어순 반례, 합계 벡터와 주제어, 원-핫·희소성 질문, COUNTIF와 연습 5문항 보강 (에이전트 수정, 그림 1→5)
- 2026-11-17 · 전수 검수(에이전트 편집·독립 검증) 통과 — 주인 요청으로 완성으로 올림