직관 — 단어마다 표를 붙여 합계를 낸다
어떤 단어에는 더하기 점수를, 다른 단어에는 빼기 점수를 붙인다. 문서에 나온 만큼 점수를 모으면 간단한 판정 규칙을 만들 수 있다. 그러나 합계표에는 그 단어가 칭찬인지 비꼼인지 알아보는 능력이 저절로 생기지 않는다.
단어에 붙인 표는 감성 점수, 표를 모아 둔 목록은 감성 사전, 합계는 문서의 총점에 대응한다. 단어가방 모형의 횟수를 쓰면 같은 단어가 여러 번 나올 때의 점수를 한꺼번에 계산할 수 있다. 상품 리뷰를 긍정·부정으로 나누는 감성 분석의 가장 단순한 형태이며, 단어 점수는 인공지능 모형의 가중치처럼 곱해서 더하는 수다.
사전 기반 감성 분석은 영어로 lexicon-based sentiment analysis다. 이 글은 학습용 사전을 직접 정해 계산 규칙과 한계를 확인하며, 사람의 감정을 확정하는 도구로 사용하지 않는다.
사전 기반 감성 분석은 단어 점수와 횟수를 곱해 더한다
사전 기반 감성 분석은 감성 사전의 단어마다 점수에 등장 횟수를 곱하고, 그 값을 모두 더해 문서의 총점을 구한다. 감성 사전은 단어나 표현에 미리 감성 점수를 붙여 둔 자료다. 사전에 단어가 개 있으면 총점 는 다음과 같다.
| 기호 | 이름 | 원어 | 뜻 |
|---|---|---|---|
| 사전의 단어 | lexicon entry | 점수를 정해 둔 번째 단어 | |
| 단어 점수 | sentiment score | 사전에서 에 붙인 양수 또는 음수 | |
| 등장 횟수 | term count | 문서에서 가 나온 횟수 | |
| 사전의 크기 | lexicon size | 점수를 정해 둔 단어의 개수 | |
| 문서 점수 | document score | 단어별 점수에 횟수를 곱해 더한 총점 |
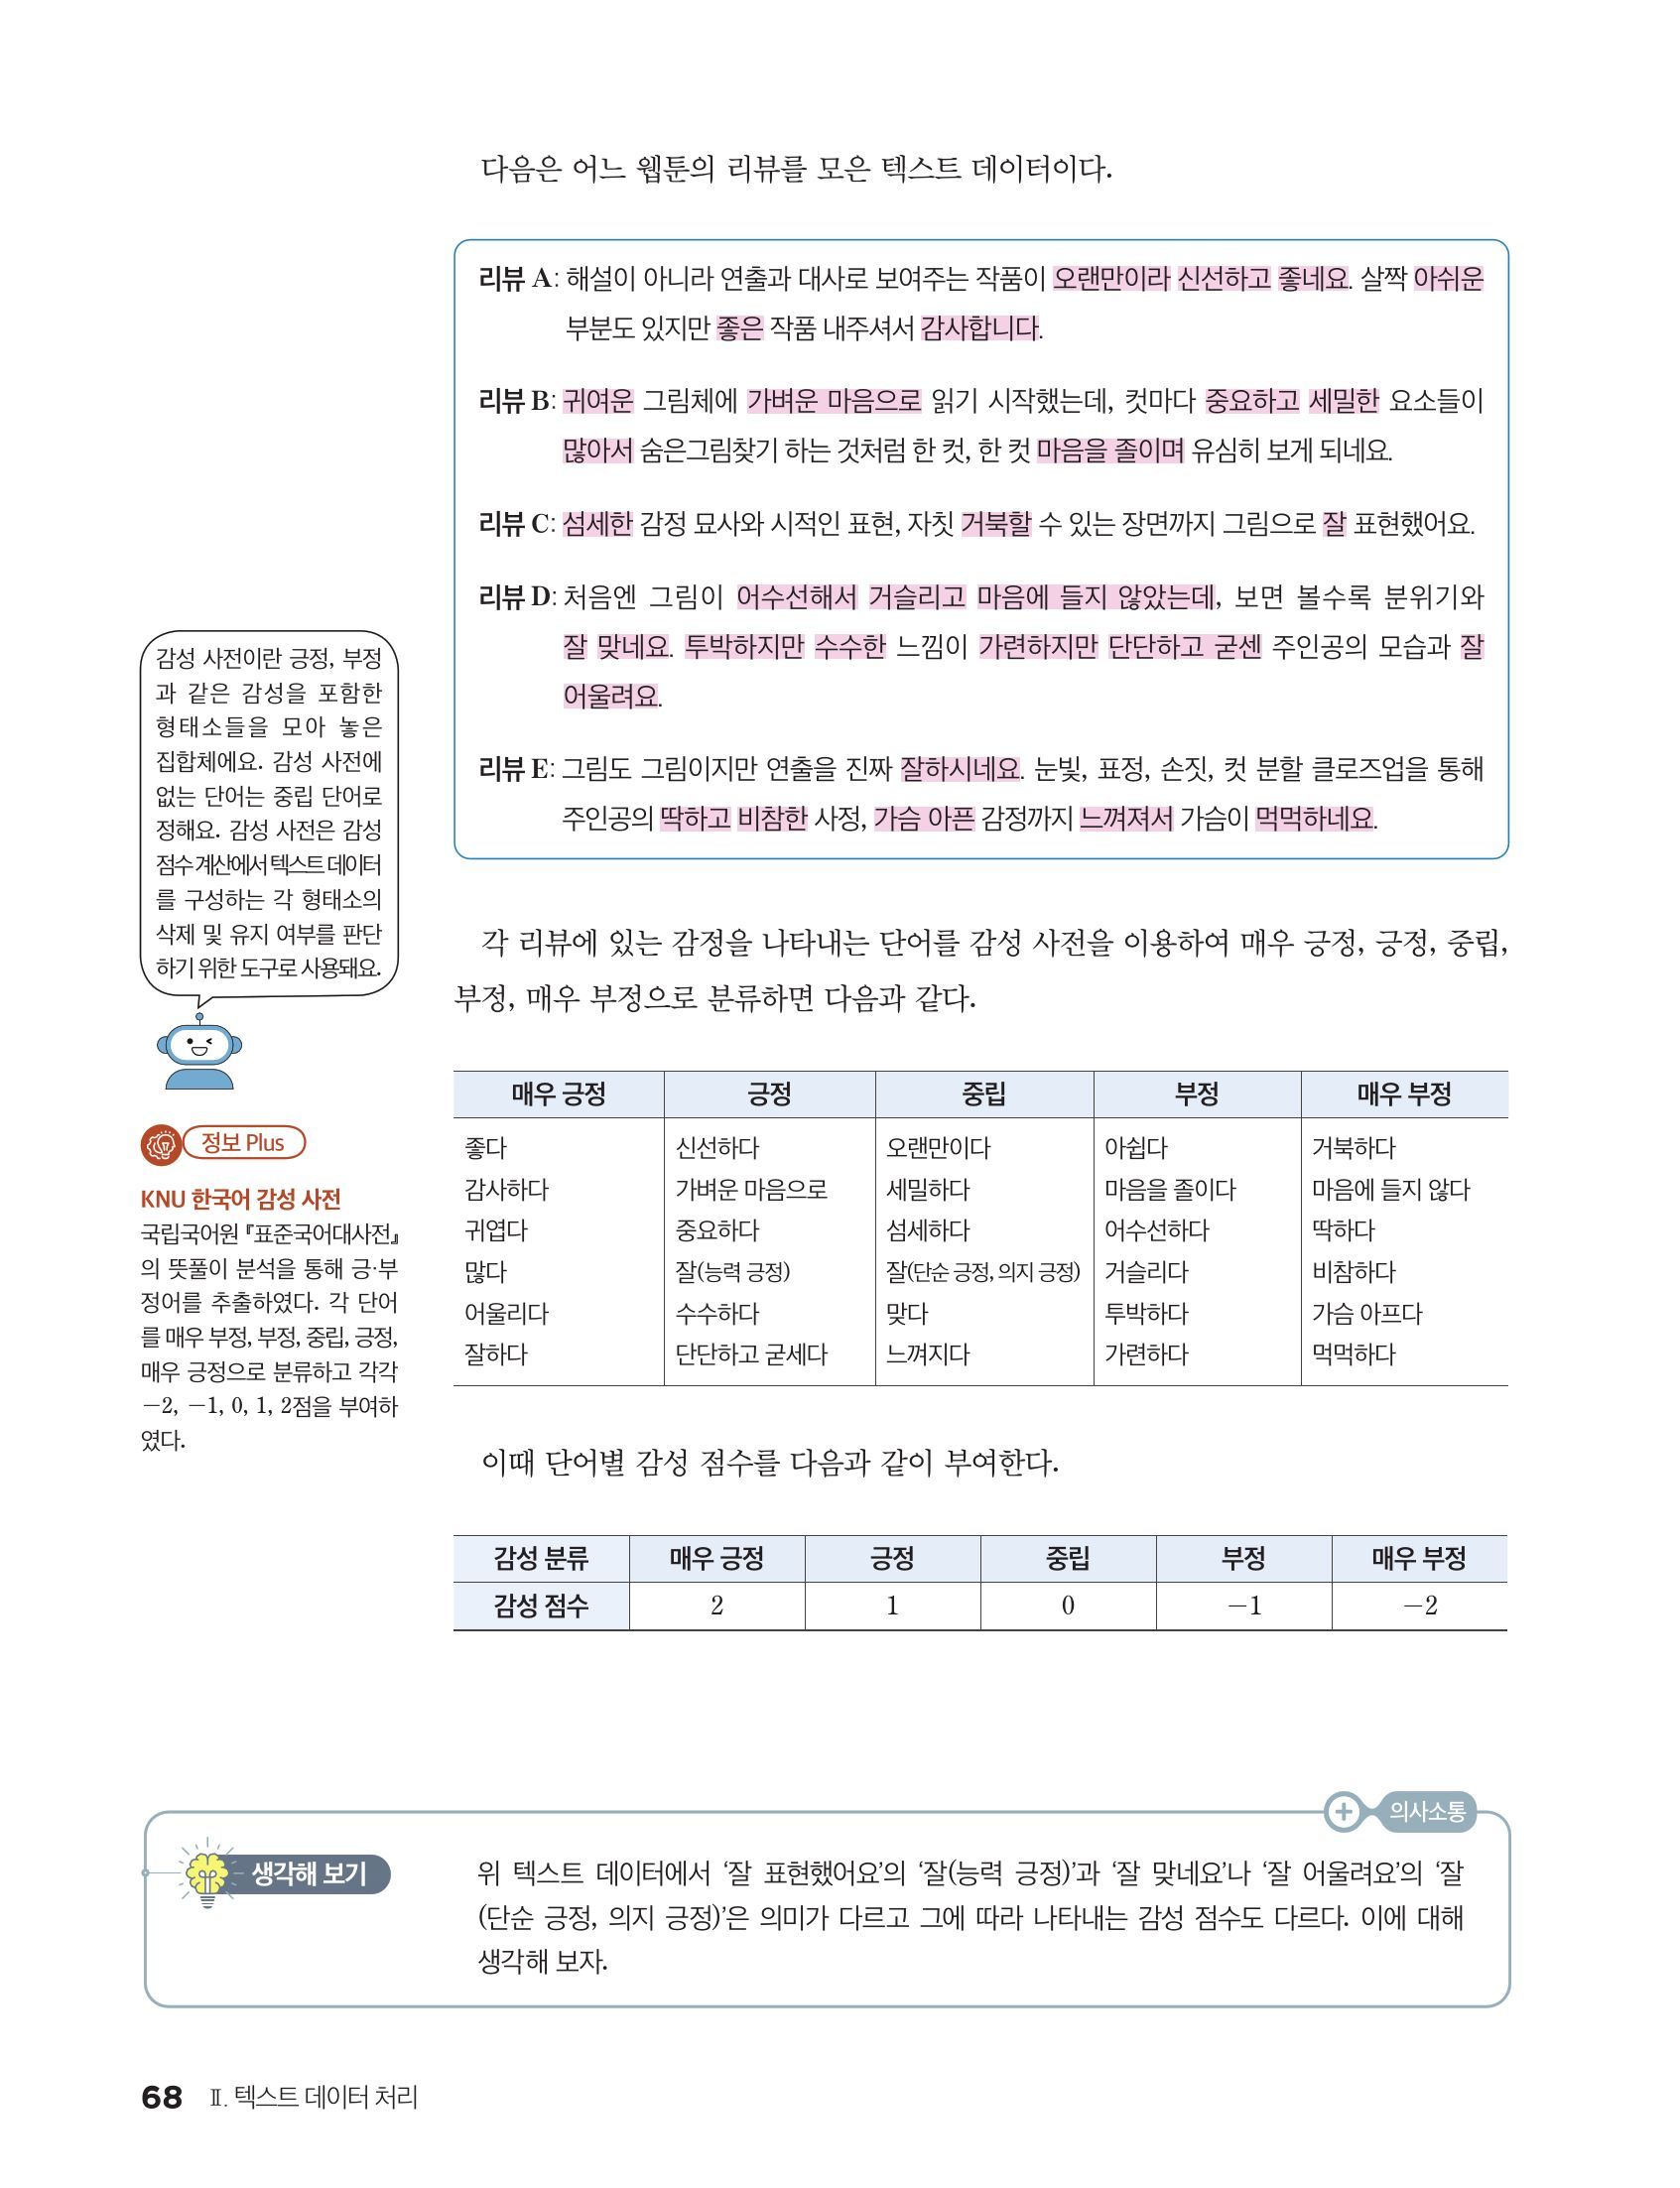
교과서는 KNU 한국어 감성 사전처럼 단어를 매우 긍정 2, 긍정 1, 중립 0, 부정 −1, 매우 부정 −2의 다섯 단계로 나눈 점수를 쓴다. 이 글의 학습용 사전도 같은 눈금에서 네 단어를 골랐다. 실제 평가 자료에서 추정한 사전이 아니라 덧셈과 판정의 원리를 배우려고 만든 사전이다.
| 단어 | 좋다 | 친절하다 | 느리다 | 불편하다 |
|---|---|---|---|---|
| 점수 | 2 | 1 | −1 | −2 |
이 사전에서는 이므로 식 (1)은 다음과 같다.
예를 들어 ‘좋다’가 두 번이면 다. 같은 점수를 횟수만큼 더하는 일을 곱셈으로 줄였으므로 점수와 횟수를 곱해서 더한다. 판정은 총점의 부호로 한다.
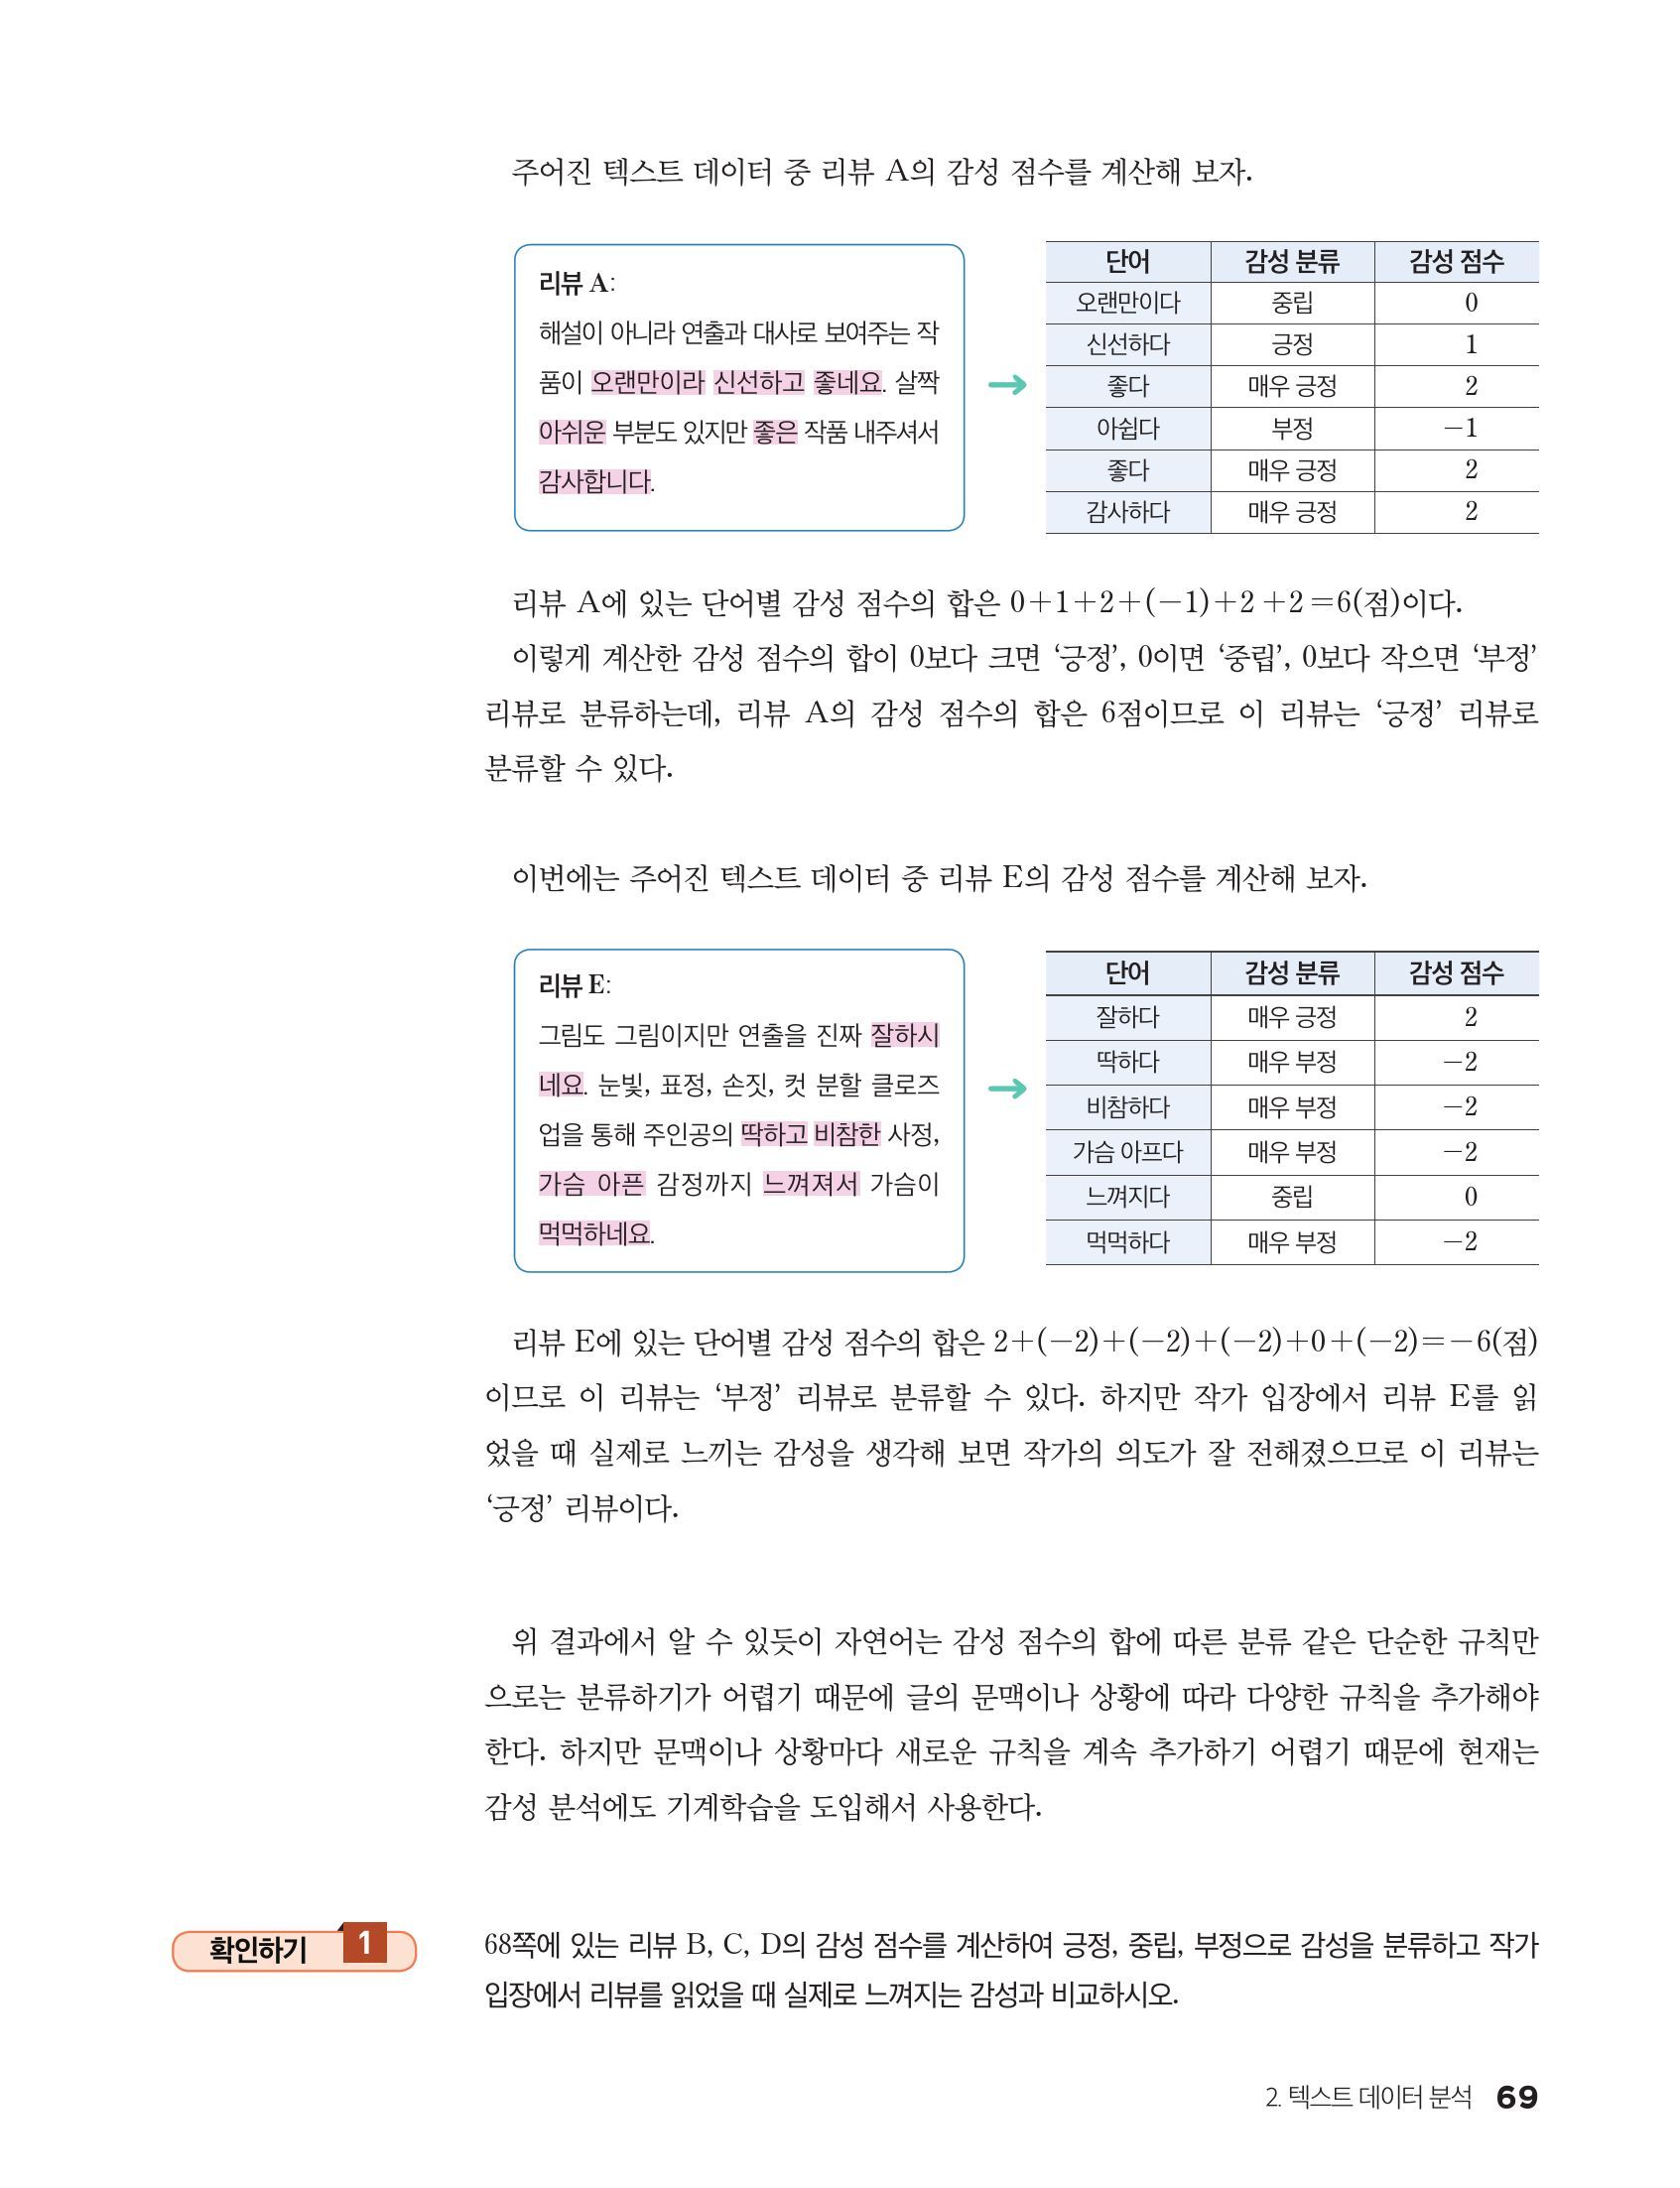
교과서는 총점이 0이면 ‘중립’으로 분류한다. 이 글은 같은 경우를 판단 보류라 부른다. 0점은 긍정과 부정이 상쇄될 때도, 사전 단어가 하나도 없을 때도 생기므로 실제 뜻이 중립인지 원문을 다시 봐야 하기 때문이다.
문서는 마침표를 지운 뒤 공백으로 나누며, 사전에 정확히 일치하는 단어만 집계한다. ‘좋아요’를 ‘좋다’로 바꾸는 기능은 이 작은 규칙에 없다. 교과서처럼 사전에 없는 토큰은 계산상 0점으로 두되, 그 토큰들은 따로 기록한다.
같은 감성 사전으로 세 문서를 계산해 보자
다음은 형태를 단순하게 만든 가상 문서다. 문서 A는 ‘좋다 친절하다 좋다 느리다’, B는 ‘느리다 불편하다’, C는 ‘좋다 불편하다’로 정한다. 횟수 벡터는 사전 순서인 좋다·친절하다·느리다·불편하다의 횟수 다.
| 문서 | 횟수 벡터 | 식 (2)에 대입 | 총점·판정 |
|---|---|---|---|
| A | 4, 긍정 | ||
| B | −3, 부정 | ||
| C | 0, 보류 |
그림 1에서 A의 양수 기여는 4와 1, 음수 기여는 −1이다. 각 막대는 단어 점수 자체가 아니라 점수에 횟수를 곱한 기여량이다. ‘좋다’는 2점이지만 두 번 나와서 막대가 4다.

figures/sentiment_contributions.py그림 2는 세 문서와 사전 밖 문서 D ‘환상적이다’의 총점을 수직선에 놓은 것이다. A는 4로 긍정 구간에, B는 −3으로 부정 구간에 있다. C와 D는 둘 다 0이라 판단 보류다. 그러나 C는 ‘좋다’의 2와 ‘불편하다’의 −2가 상쇄된 것이고, D는 사전 단어가 하나도 없는 것이다.

figures/score_number_line.py사전 기반 감성 분석에서 사전에 없는 말은 중립일까?
사전 기반 감성 분석에서 사전에 없는 말은 계산상 0점일 뿐, 실제로 중립이라는 보장은 없다. 그림 2의 D ‘환상적이다’는 칭찬이지만 이 사전으로는 0점이다. 미등록 표현을 따로 남겨 두어야 사전을 보완할 수 있다.
사전 기반 감성 분석의 점수는 확률일까?
아니다. 사전 기반 감성 분석의 점수 4나 −3은 단어별 기여를 더한 수이며, 확률처럼 0과 1 사이에 있을 필요가 없다. 4점이라고 긍정일 확률이 4배라는 뜻도 아니다.
사전 기반 감성 분석에서 ‘안 좋다’는 왜 틀릴까?
기본 규칙은 ‘안’에 점수가 없으므로 ‘안 좋다’도 ‘좋다’와 똑같이 , 긍정으로 계산한다. 이는 덧셈 실수가 아니라 단어를 따로 계산하는 모형의 한계다. 그림 3의 첫째 줄이 이 계산이다.
한 가지 개선으로 ‘안’ 바로 뒤에 사전 단어가 오면 그 단어 점수의 부호를 한 번 바꾸는 규칙을 더해 보자. ‘안 좋다’는 , ‘안 불편하다’는 가 된다(그림 3의 둘째 줄). 이 규칙은 단어의 순서를 보므로 빈도수 벡터만으로는 처리할 수 없다.
하지만 ‘안 정말 좋다’에서는 바로 다음 토큰이 ‘정말’이라 이 좁은 규칙이 작동하지 않는다. 그림 3의 셋째 줄처럼 총점은 그대로 2다. 규칙이 보는 범위를 넓히면 이번에는 ‘안’과 상관없는 먼 단어까지 뒤집을 위험이 생긴다.

figures/negation_rule.py교과서의 감성 사전에는 ‘마음에 들지 않다’처럼 여러 낱말로 된 표현이 한 항목으로 들어 있다. ‘안 좋다’를 −2점짜리 묶음 항목으로 올리면 ‘안 좋다’는 −2가 된다. 그러나 사이에 낱말이 끼는 ‘안 정말 좋다’는 여전히 2점이다. 규칙이나 항목을 더할수록 맞는 문장은 늘지만, 그 규칙이 보지 못하는 문장은 계속 남는다.
사전 기반 감성 분석은 반어와 다의어를 왜 구별하지 못할까?
사전은 한 단어에 점수 하나만 붙이므로, 단어가 놓인 상황이 달라도 같은 값을 더하기 때문이다. ‘참 좋다 세 시간 기다리다’를 기다림을 비꼬는 반어로 썼어도, 사전 단어는 ‘좋다’뿐이라 로 긍정 판정이 나온다.
다의어도 같은 문제다. 사전에 ‘가볍다’를 1점으로 하나 더 올렸다고 하자. ‘가방 가볍다’는 칭찬이고 ‘약속 가볍다’는 비판이지만, 두 문장 모두 로 긍정이다. 교과서도 ‘잘’이 뜻에 따라 다른 감성 점수를 받는 예로 같은 문제를 생각해 보게 한다.
그림 4는 지금까지 본 다섯 문장을 한데 모은 것이다. 점은 계산한 총점이고, 화살표는 사람이 읽은 뜻의 방향이다. 다섯 문장 가운데 총점의 부호와 뜻의 방향이 맞는 문장은 ‘가방 가볍다’ 하나뿐이다.

figures/failure_cases.py교과서도 문맥과 상황마다 규칙을 계속 더하기는 어렵다고 보고, 감성 분석에 기계학습을 쓴다고 설명한다. 식 (1)은 입력에 가중치를 곱해 더하는 퍼셉트론의 가중합과 모양이 같다. 다른 점은 점수 를 사람이 정하느냐, 정답이 붙은 리뷰에서 기계학습으로 찾느냐다.
사전 기반 감성 분석의 총점은 단어 점수에 등장 횟수를 곱해 더한 값이며, 0점은 상쇄나 사전 밖 표현 때문에도 생기므로 중립으로 확정하지 않고 원인을 확인한다.
사전 기반 감성 분석의 흔한 오해
- 부정적인 단어가 있으면 문서 전체도 부정이다. — A에는 ‘느리다’가 있지만 식 (2)의 총점은 4로 긍정이다. 반대로 이 긍정 판정 역시 글의 실제 의도를 보증하지 않는다.
- 규칙을 만든 예제에서 맞았으니 다른 리뷰에도 잘 맞는다. — 그 자료는 규칙을 정하는 데 이미 사용했다. 새로운 문서와 사람이 문맥을 보고 붙인 분류를 따로 비교해야 새 자료에서의 성능을 평가할 수 있다.
사전 기반 감성 분석은 원문을 함께 살피는 출발점이다
수업에서는 가상 문서를 먼저 사람이 읽고 긍정·부정·판단 어려움으로 나눠 보자. 사전 계산과 다른 사례를 찾아 부정어, 반어, 다의어, 사전 밖 표현, 상쇄 가운데 무엇 때문인지 적는다. 텍스트 유사도처럼 수학적 기준을 명시해야 결과를 재현할 수 있다. TF-IDF의 중요도와 감성 점수는 목적이 다르므로 서로 대신하지 않는다.
사전 기반 감성 분석에서 더 긴 문서는 더 긍정적일까?
사전 기반 감성 분석의 총점은 문서 길이가 아니라 사전 단어의 점수와 횟수로 정해진다. ‘좋다’ 한 단어는 2점이지만, ‘불편하다’를 덧붙인 두 단어 문서는 0점이다. 반대로 A를 그대로 두 번 이어 쓰면 내용은 같아도 총점이 4에서 8이 되므로, 길이의 영향을 줄이려면 토큰이 하나 이상인 문서에서 총점을 사전 밖 토큰까지 센 전체 토큰 수로 나눈 평균을 쓰기도 한다.
사전 기반 감성 분석과 유사도로 분류하는 방법은 결과가 같을까?
사전 기반 감성 분석과 유사도 분류는 같은 문서를 다르게 판정할 수 있다. ‘좋다 좋다 느리다 불편하다’는 식 (2)로 이라 긍정이다. 그런데 양수 점수 단어 {좋다, 친절하다}, 음수 점수 단어 {느리다, 불편하다}와의 자카드 유사도는 과 이라 부정 쪽에 더 가깝다. 자카드는 반복 횟수와 점수의 크기를 버리기 때문이다.
직접 해보기
어휘 순서는 좋다·친절하다·느리다·불편하다다.
- ‘친절하다 친절하다 느리다’의 횟수 벡터·총점·판정을 구하자.
- ‘불편하다 좋다 느리다’의 총점과 판정을 구하자.
- ‘안 친절하다’에 기본 규칙과 ‘안 바로 다음 단어’ 규칙을 각각 적용하자.
- ‘친절하다 느리다’와 ‘최고다’가 같은 점수일 때, 두 원문이 같은 뜻이라고 할 수 없는 이유를 설명하자.
- ‘좋다 좋다 느리다’와 ‘좋다’의 총점, 그리고 총점을 전체 토큰 수로 나눈 평균 점수를 구하자. 두 기준에서 어느 문서가 더 긍정적인지 비교하자.
답과 풀이
- 이고 이므로 긍정이다.
- 이고 이므로 부정이다.
- 기본 규칙에서는 ‘안’이 0이고 ‘친절하다’가 1이므로 총점 1, 긍정이다. 개선 규칙에서는 바로 뒤의 1을 −1로 바꾸어 총점 −1, 부정으로 판정한다.
- 첫 문서는 으로 상쇄되고, 둘째는 사전 밖 단어라 0이다. 두 경우 모두 보류하지만 0이 된 이유와 실제 뜻은 다르다.
- 총점은 과 2로 첫 문서가 크다. 평균은 과 로 둘째 문서가 크다. 총점과 평균 가운데 무엇을 기준으로 정하느냐에 따라 순서가 바뀐다.
더 읽기
- 교육부, 2022 개정 수학과 교육과정 — 인공지능 수학 [12인수02-03]과 해설. 단어의 감성 점수를 이용해 텍스트 자료를 분석하고 결과를 해석하는 범위를 확인했다.
- 씨마스, 고등학교 인공지능 수학 68쪽 — 윤상운 외, 2022 개정판. 감성 사전의 뜻, KNU 한국어 감성 사전의 다섯 단계 점수, 같은 낱말의 뜻에 따라 점수가 달라지는 활동이 있다.
- 씨마스, 69쪽 — 리뷰의 감성 점수 합으로 긍정·중립·부정을 나누는 규칙과, 단순 규칙의 한계 때문에 기계학습을 쓴다는 설명을 확인할 수 있다.
영상 노트
- 00:00 0점이면 중립인가라는 질문 던지기
- 00:40 식 (1)·(2)로 점수와 횟수를 곱해 더하는 이유, 식 (3)의 판정 규칙 판서
- 02:00 세 문서의 표와 그림 1의 기여량 막대 맞춰 보기
- 03:00 그림 2에서 같은 0점의 두 원인(상쇄와 사전 밖) 구별하기
- 04:00 그림 3으로 부정어 규칙이 고치는 문장과 못 고치는 문장 보여 주기
- 05:30 그림 4로 반어·다의어의 실패 정리, 퍼셉트론 가중치와의 연결
- 07:00 유사도 분류와의 비교 질문과 직접 해보기 5번 풀이
지도에서의 위치
- 2026-11-16 · 에이전트 초안 — 정의·계산·실패 사례·새 연습 작성
- 2026-11-17 · 전수 검수 반영 — 일반 꼴·판정 규칙 식과 교과서 다섯 단계 점수·중립 표기 연결, 반어 총점·다의어 사례·묶음 항목 규칙·기계학습 연결·유사도 분류 비교·전체 토큰 수로 나눈 평균 점수 연습 추가 (에이전트 수정, 그림 1→4)
- 2026-11-17 · 전수 검수(에이전트 편집·독립 검증) 통과 — 주인 요청으로 완성으로 올림