직관 — 같은 두 바구니도 비교 기준에 따라 순서가 달라진다
두 과일 바구니를 비교할 때 같은 종류가 들어 있는지, 개수까지 같은지 따로 물을 수 있다. 모든 과일을 두 배로 담으면 종류와 비율은 그대로지만 개수 차이는 커진다. 문서의 유사도도 어떤 표현으로 무엇을 비교했는지 함께 읽어야 한다.
과일의 종류는 단어 집합에, 과일별 개수는 빈도수 벡터에 대응한다. 종류의 겹침은 자카드 유사도가, 개수의 차이는 유클리드 유사도가, 개수의 비율은 코사인 유사도가 잰다. 검색 엔진과 추천 시스템도 문서와 검색어를 수로 바꾼 뒤 유사도가 큰 문서부터 보여 준다.
교과서는 텍스트 사이의 비슷한 정도를 수로 나타낸 것을 유사도라 하고, 집합으로 정의하는 유사도와 벡터로 정의하는 유사도로 나눈다. 이 글은 어휘 순서와 처리 규칙이 같은 문서끼리 비교한다. 수치가 높다는 사실만으로 실제 문장의 뜻이 같다고 단정하지 않는다.
자카드 유사도는 공통 단어의 비율이다
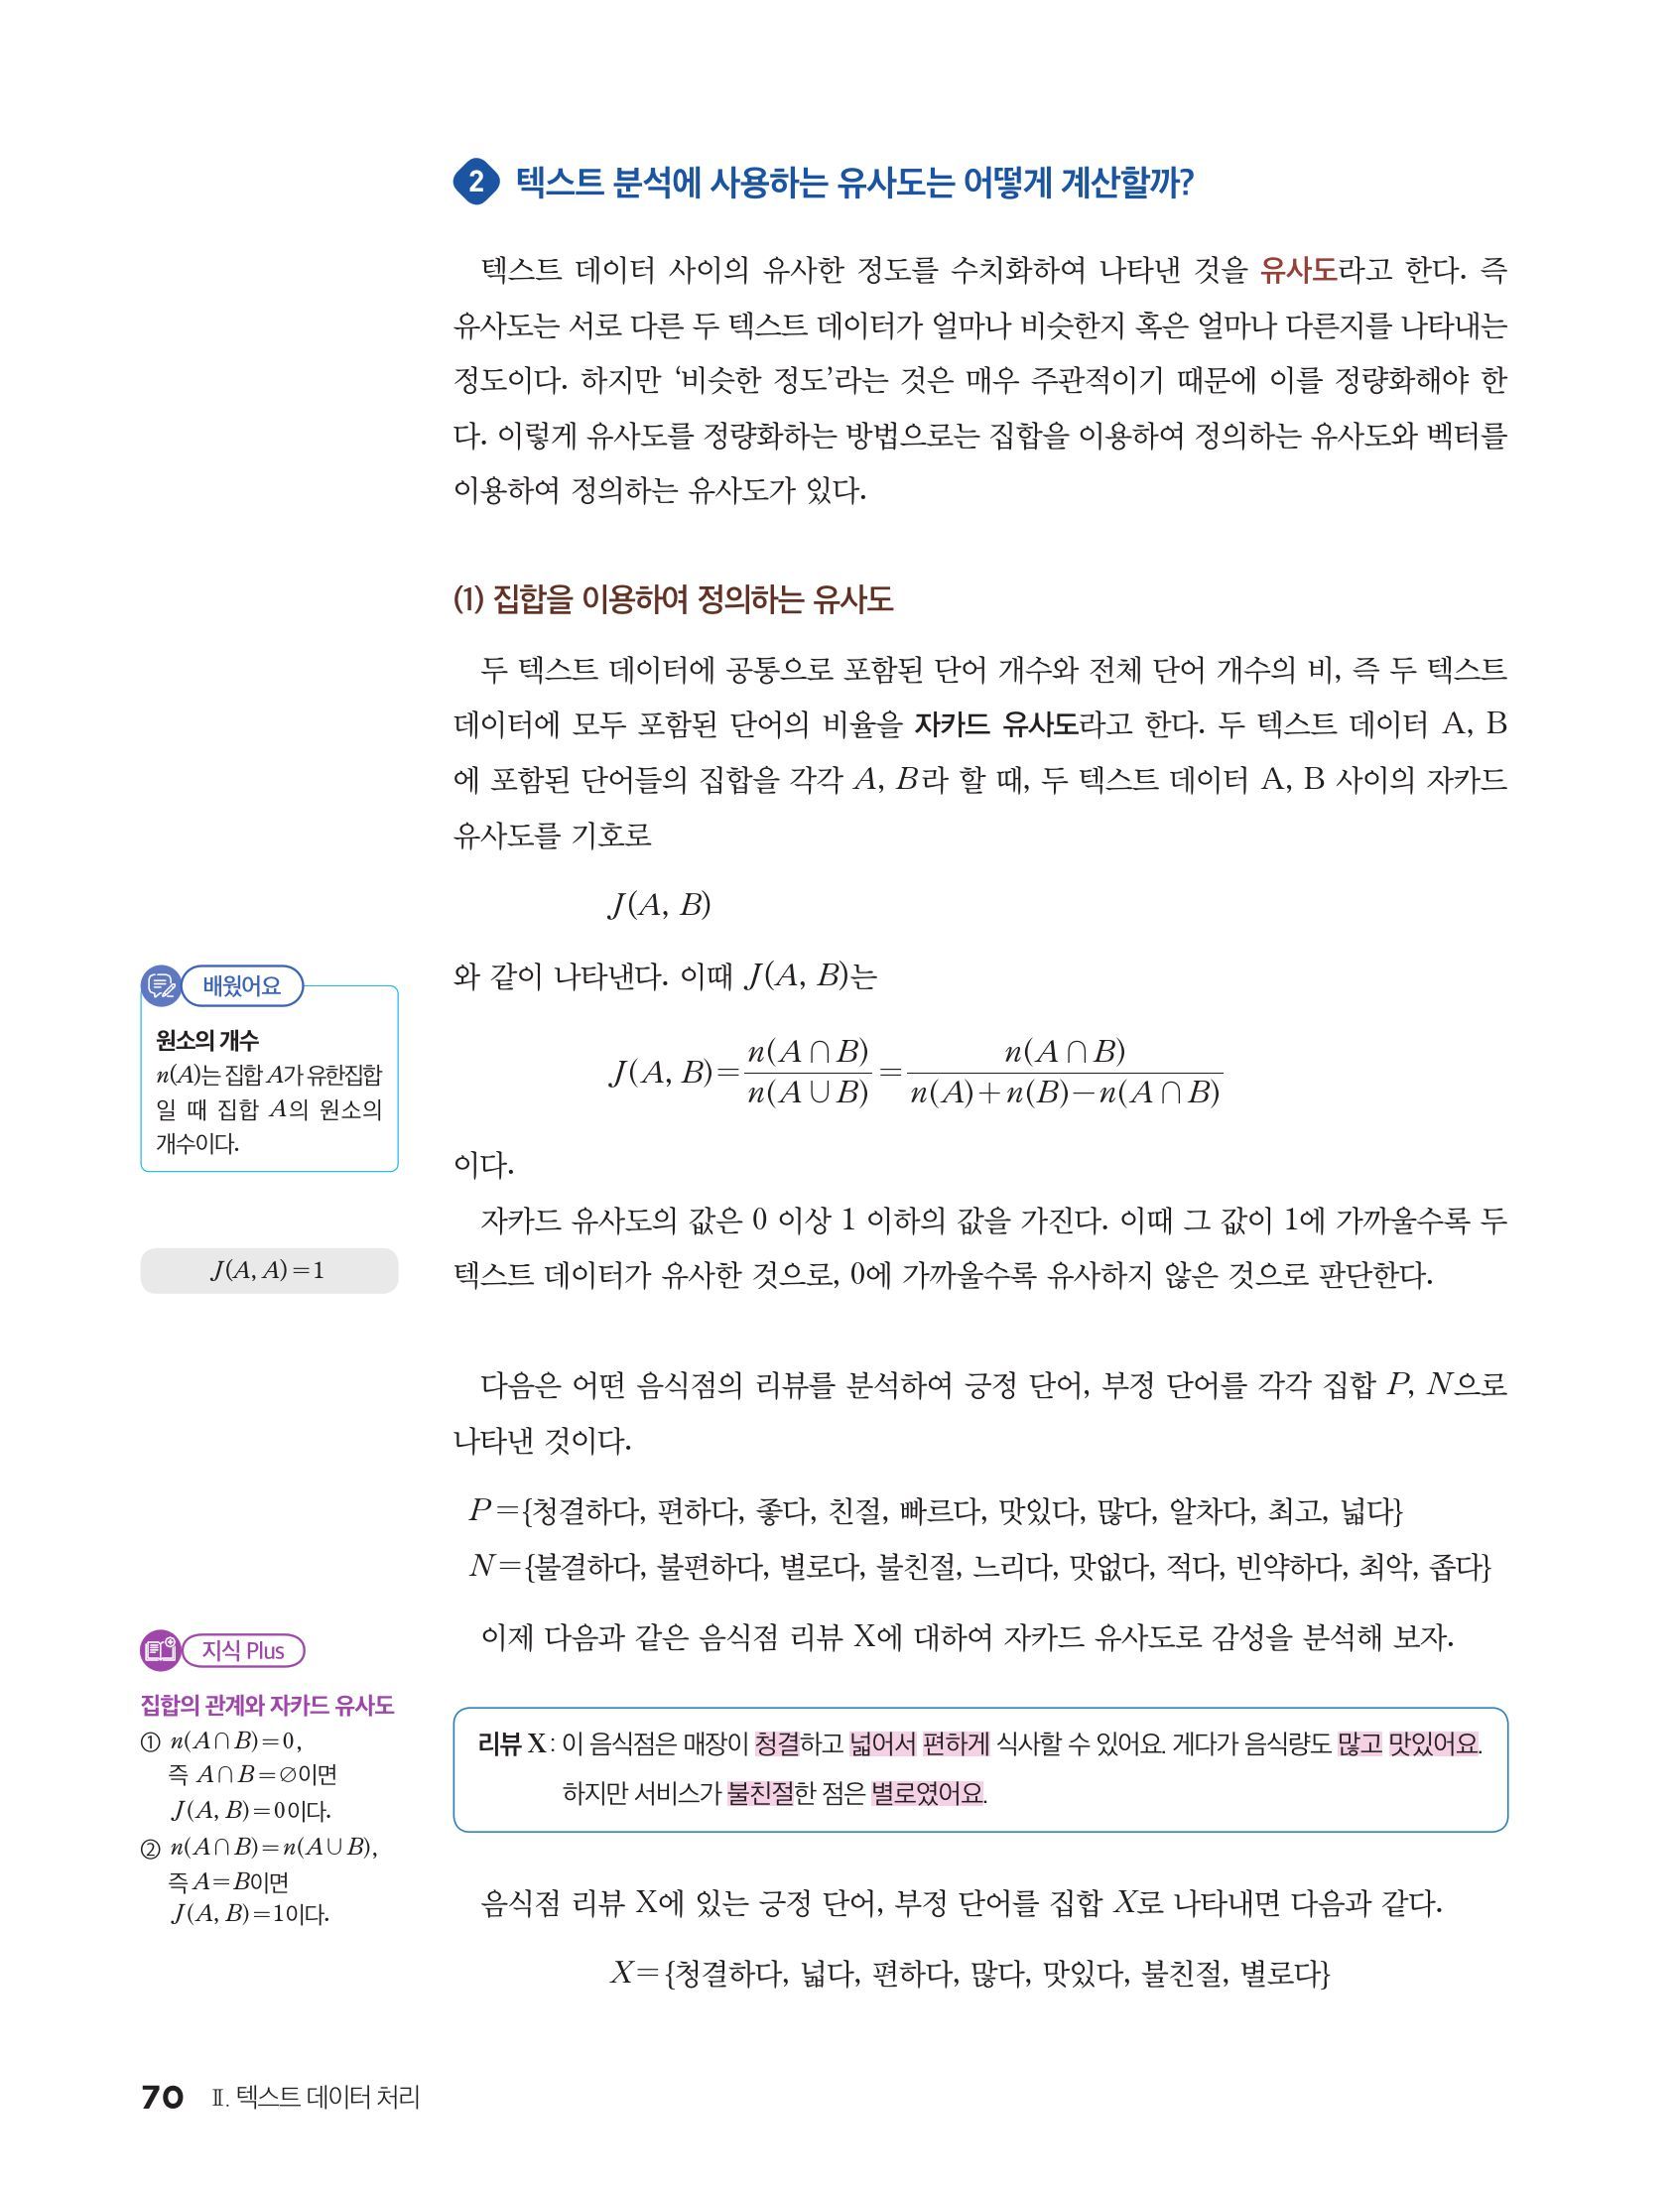
두 문서의 단어 집합을 라 하자. 자카드 유사도는 합집합이 비어 있지 않을 때, 서로 다른 단어 전체 가운데 공통 단어가 차지하는 비율이다. 집합의 원소 수는 처럼 쓴다.
| 기호 | 이름 | 원어 | 뜻 |
|---|---|---|---|
| 단어 집합 | word set | 정한 규칙으로 처리한 두 문서의 단어 종류 | |
| 원소 수 | cardinality | 집합 의 서로 다른 단어 수 | |
| 자카드 유사도 | Jaccard similarity | 공통 단어 수를 합집합의 원소 수로 나눈 값 | |
| 빈도수 벡터 | count vector | 같은 어휘 순서의 음이 아닌 횟수 배열 | |
| 성분 | component | 같은 번째 단어의 횟수 | |
| 유클리드 유사도 | Euclidean distance | 대응하는 횟수 차이의 제곱합에 제곱근을 취한 거리 | |
| 코사인 유사도 | cosine similarity | 영벡터가 아닌 두 배열의 방향을 비교하는 값 | |
| 사이각 | angle | 원점에서 그은 두 화살표가 이루는 각 |
교과서는 두 문서의 단어 집합을 로 쓰고 로 적는다. 이 페이지는 문서 이름 A, B, C와 겹치지 않도록 집합을 로 쓴다. 빈도수 벡터도 교과서의 대신 굵은 글자 로 쓴다.
합집합의 원소 수는 두 집합의 원소 수를 더한 뒤 두 번 센 교집합을 한 번 빼서 구한다. 이를 분모에 넣으면 두 집합의 크기만으로 계산하는 꼴이 된다.
공통 단어는 합집합에 포함되므로 분자는 0 이상이고 분모보다 클 수 없다. 따라서 자카드 유사도는 0 이상 1 이하다. 공통 단어가 없으면 0이고, 두 집합이 같으면 이다. 반복 횟수는 집합으로 바꿀 때 이미 없어졌다.
같은 가상 문서 A ‘숲 산책 숲 좋다’, B ‘바다 산책 좋다’, C ‘바다 바다 조용하다’를 비교하자. 단어 집합은 , , 다. A와 B는 원소가 각각 3개이고, 공통 단어는 산책·좋다 2개다.
B와 C는 바다만 공통이므로 이다. A와 C는 공통 단어가 없어 이다. 그림 1에서 가운데 칸의 수가 분자이고, 세 칸의 수를 더한 값이 분모다.

figures/jaccard_venn.py텍스트의 단어 집합에서 만든 0·1 존재 벡터로도 같은 값을 얻는다. 두 벡터가 모두 1인 자리의 수를, 적어도 한쪽이 1인 자리의 수로 나누면 된다.
텍스트 유사도에서 빈 문서 두 개의 자카드 유사도는 1일까?
아니다. 빈 문서 두 개의 자카드 유사도는 식 (1)로 정의되지 않는다. 합집합의 원소 수가 0이어서 분모가 0이기 때문이다. 도구가 따로 약속한 값을 쓸 수는 있지만, 이 글에서는 ‘계산 불가’로 표시하고 비교에서 제외한다.
유클리드 유사도는 단어별 횟수 차이를 어떻게 모을까?
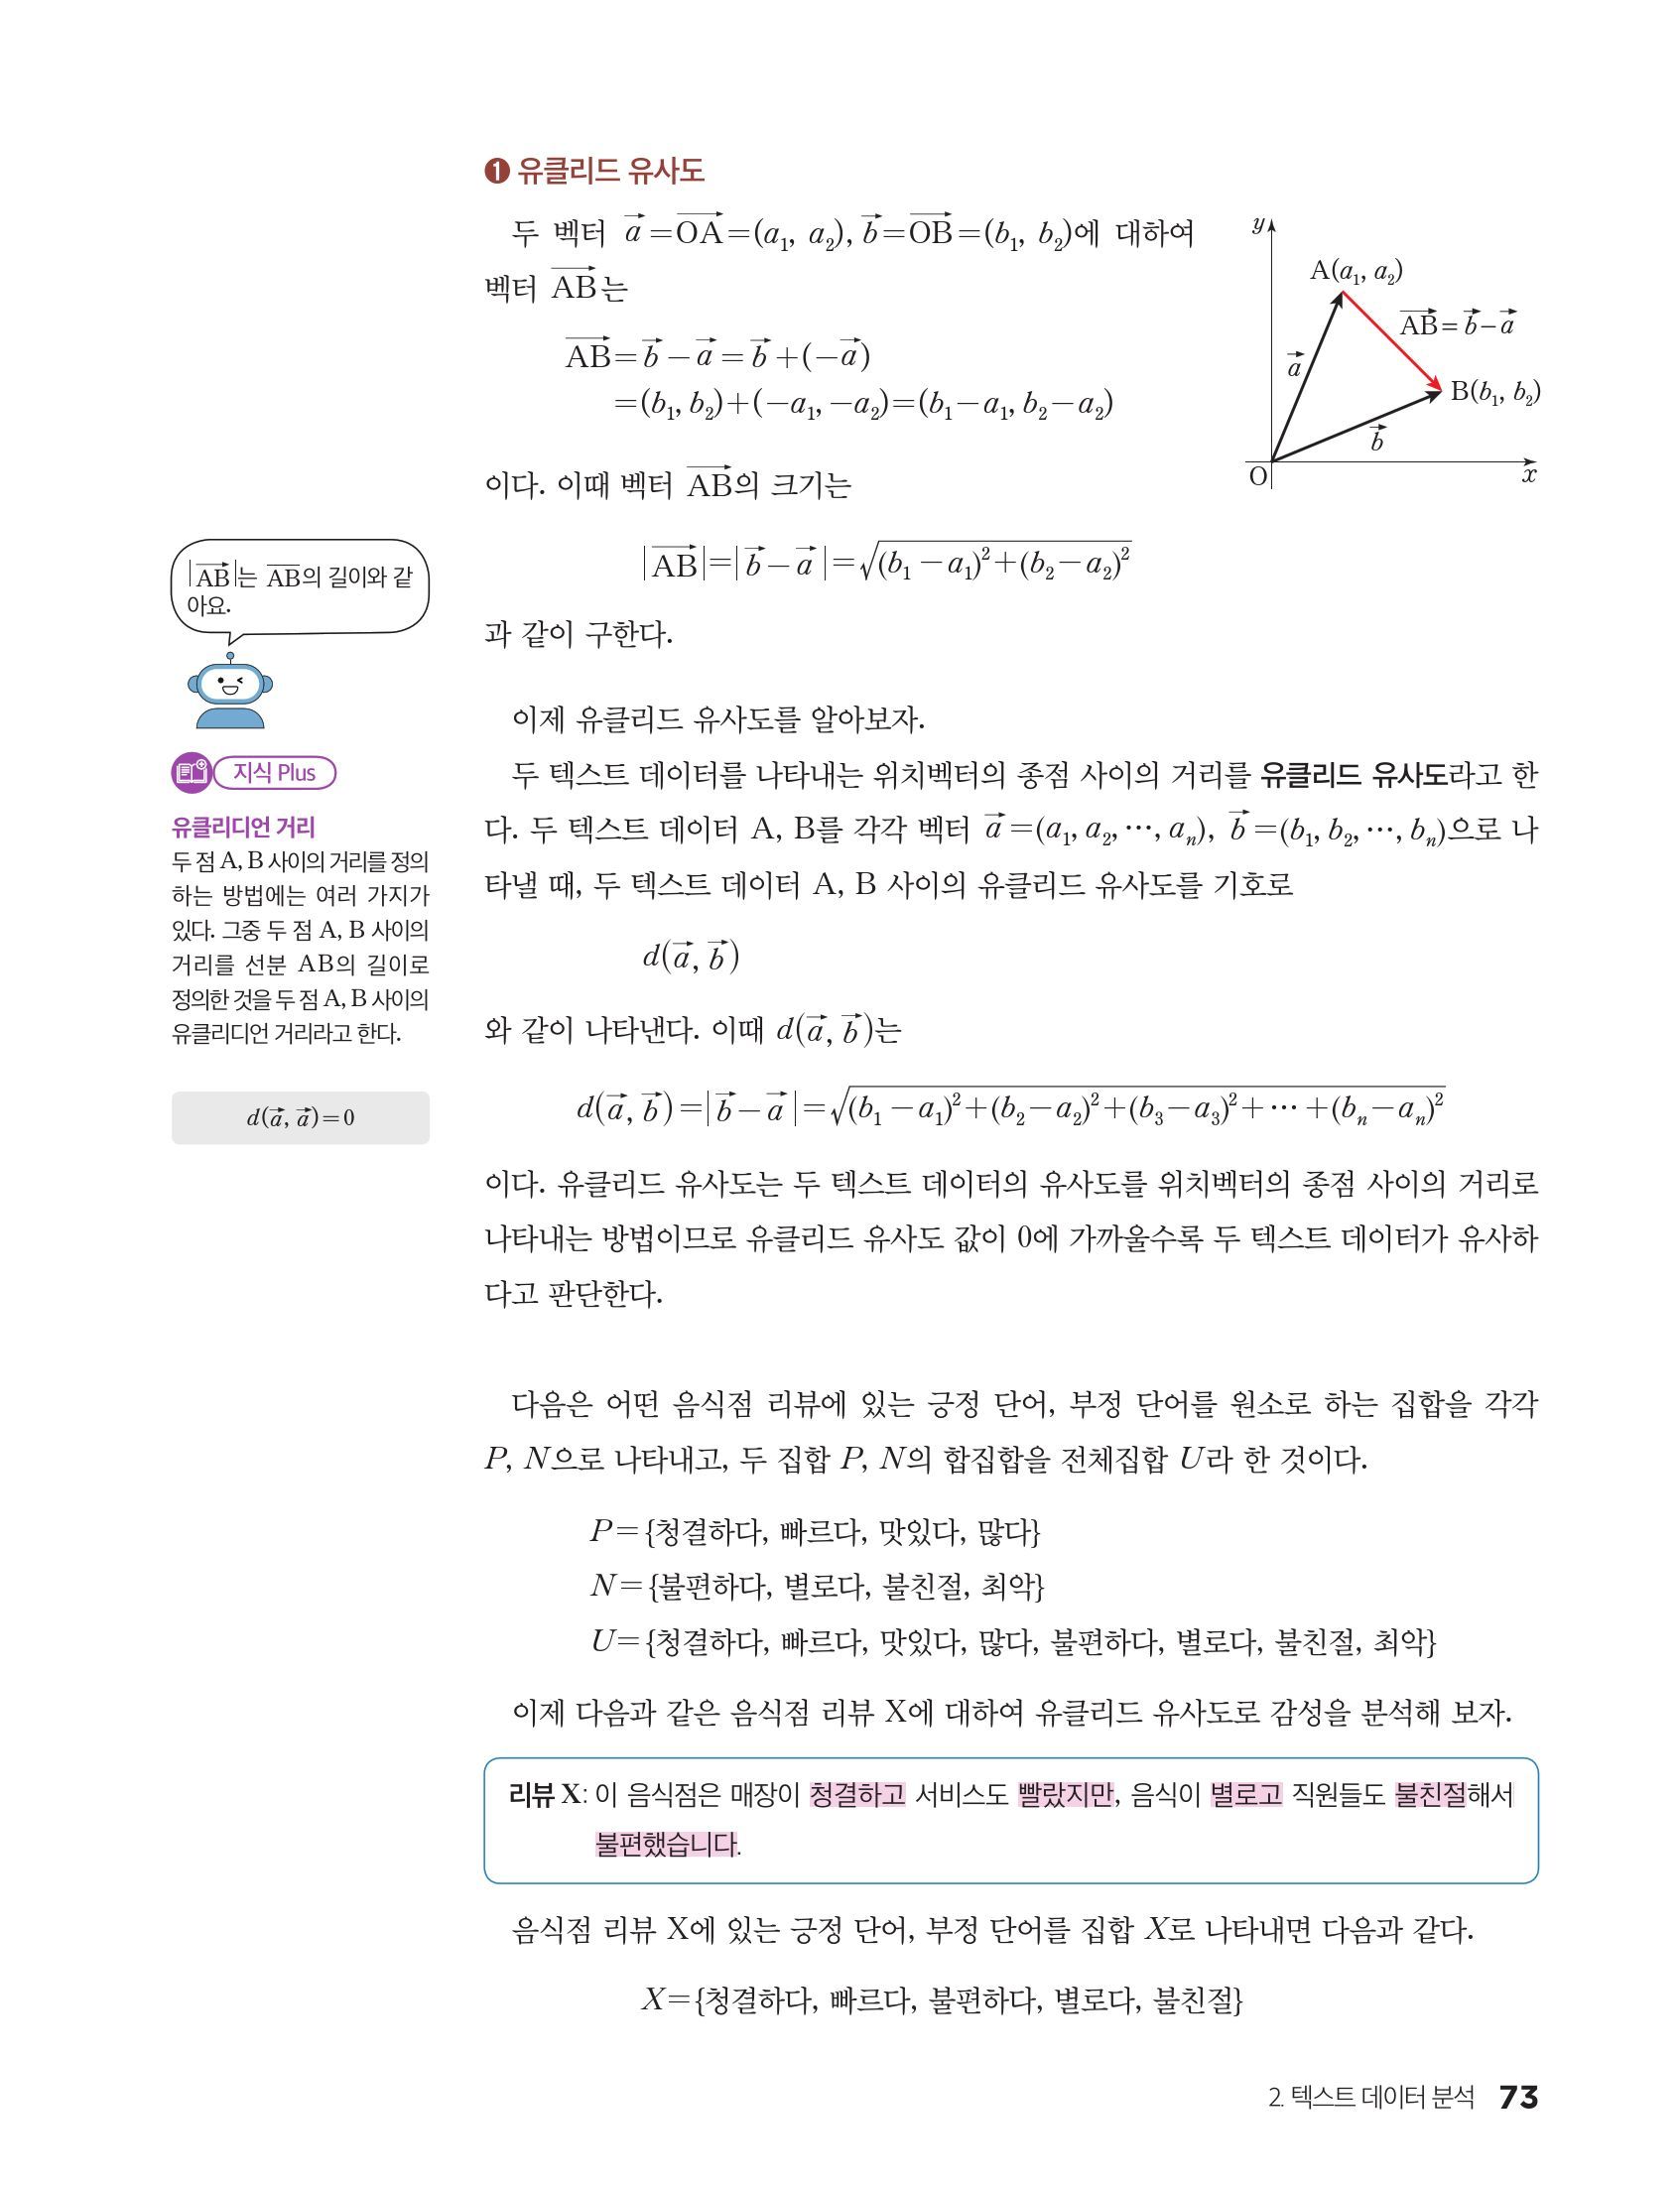
유클리드 유사도는 대응하는 성분끼리 빼고, 그 차이를 제곱해 더한 뒤 제곱근을 취한 거리다. 값이 0에 가까울수록 두 문서가 비슷하다고 판단한다. 어휘가 개이면 다음과 같다.
교과서는 두 텍스트를 나타내는 위치벡터의 종점 사이 거리를 ‘유클리드 유사도’라 부르고 로 쓴다. 이름은 유사도지만 값은 거리라서, 자카드와 달리 작을수록 가깝다. 같은 문서끼리는 이다.
식 (3)은 성분이 두 개이면 좌표평면의 두 점 사이 거리와 같다. 차이를 제곱하므로 양수 차이와 음수 차이가 서로 지워지지 않는다. 모든 차이가 0일 때에만 거리도 0이다.
어휘 순서를 숲·바다·산책·좋다·조용하다()로 정하면 , , 이다. 그림 2의 줄은 A와 B의 차이를 제곱한 값 4, 1, 0, 0, 0이고, 그 합은 5다.
B와 C는 차이가 이므로 거리는 다. A와 C는 차이가 이어서 로 가장 멀다.

figures/component_table.py텍스트 유사도에서 유클리드 거리를 클수록 비슷한 점수로 바꿀 수 있을까?
그렇다. 유클리드 유사도의 거리 를 로 바꾸면 거리 0은 1이 되고 거리가 커질수록 값이 작아진다. A와 B는 약 0.309, B와 C는 약 0.333으로 순위는 거리와 같다. 다만 바꾸는 식은 하나로 정해져 있지 않으며, 교과서의 자체와 같은 수도 아니다.
코사인 유사도는 단어 횟수의 비율을 비교한다
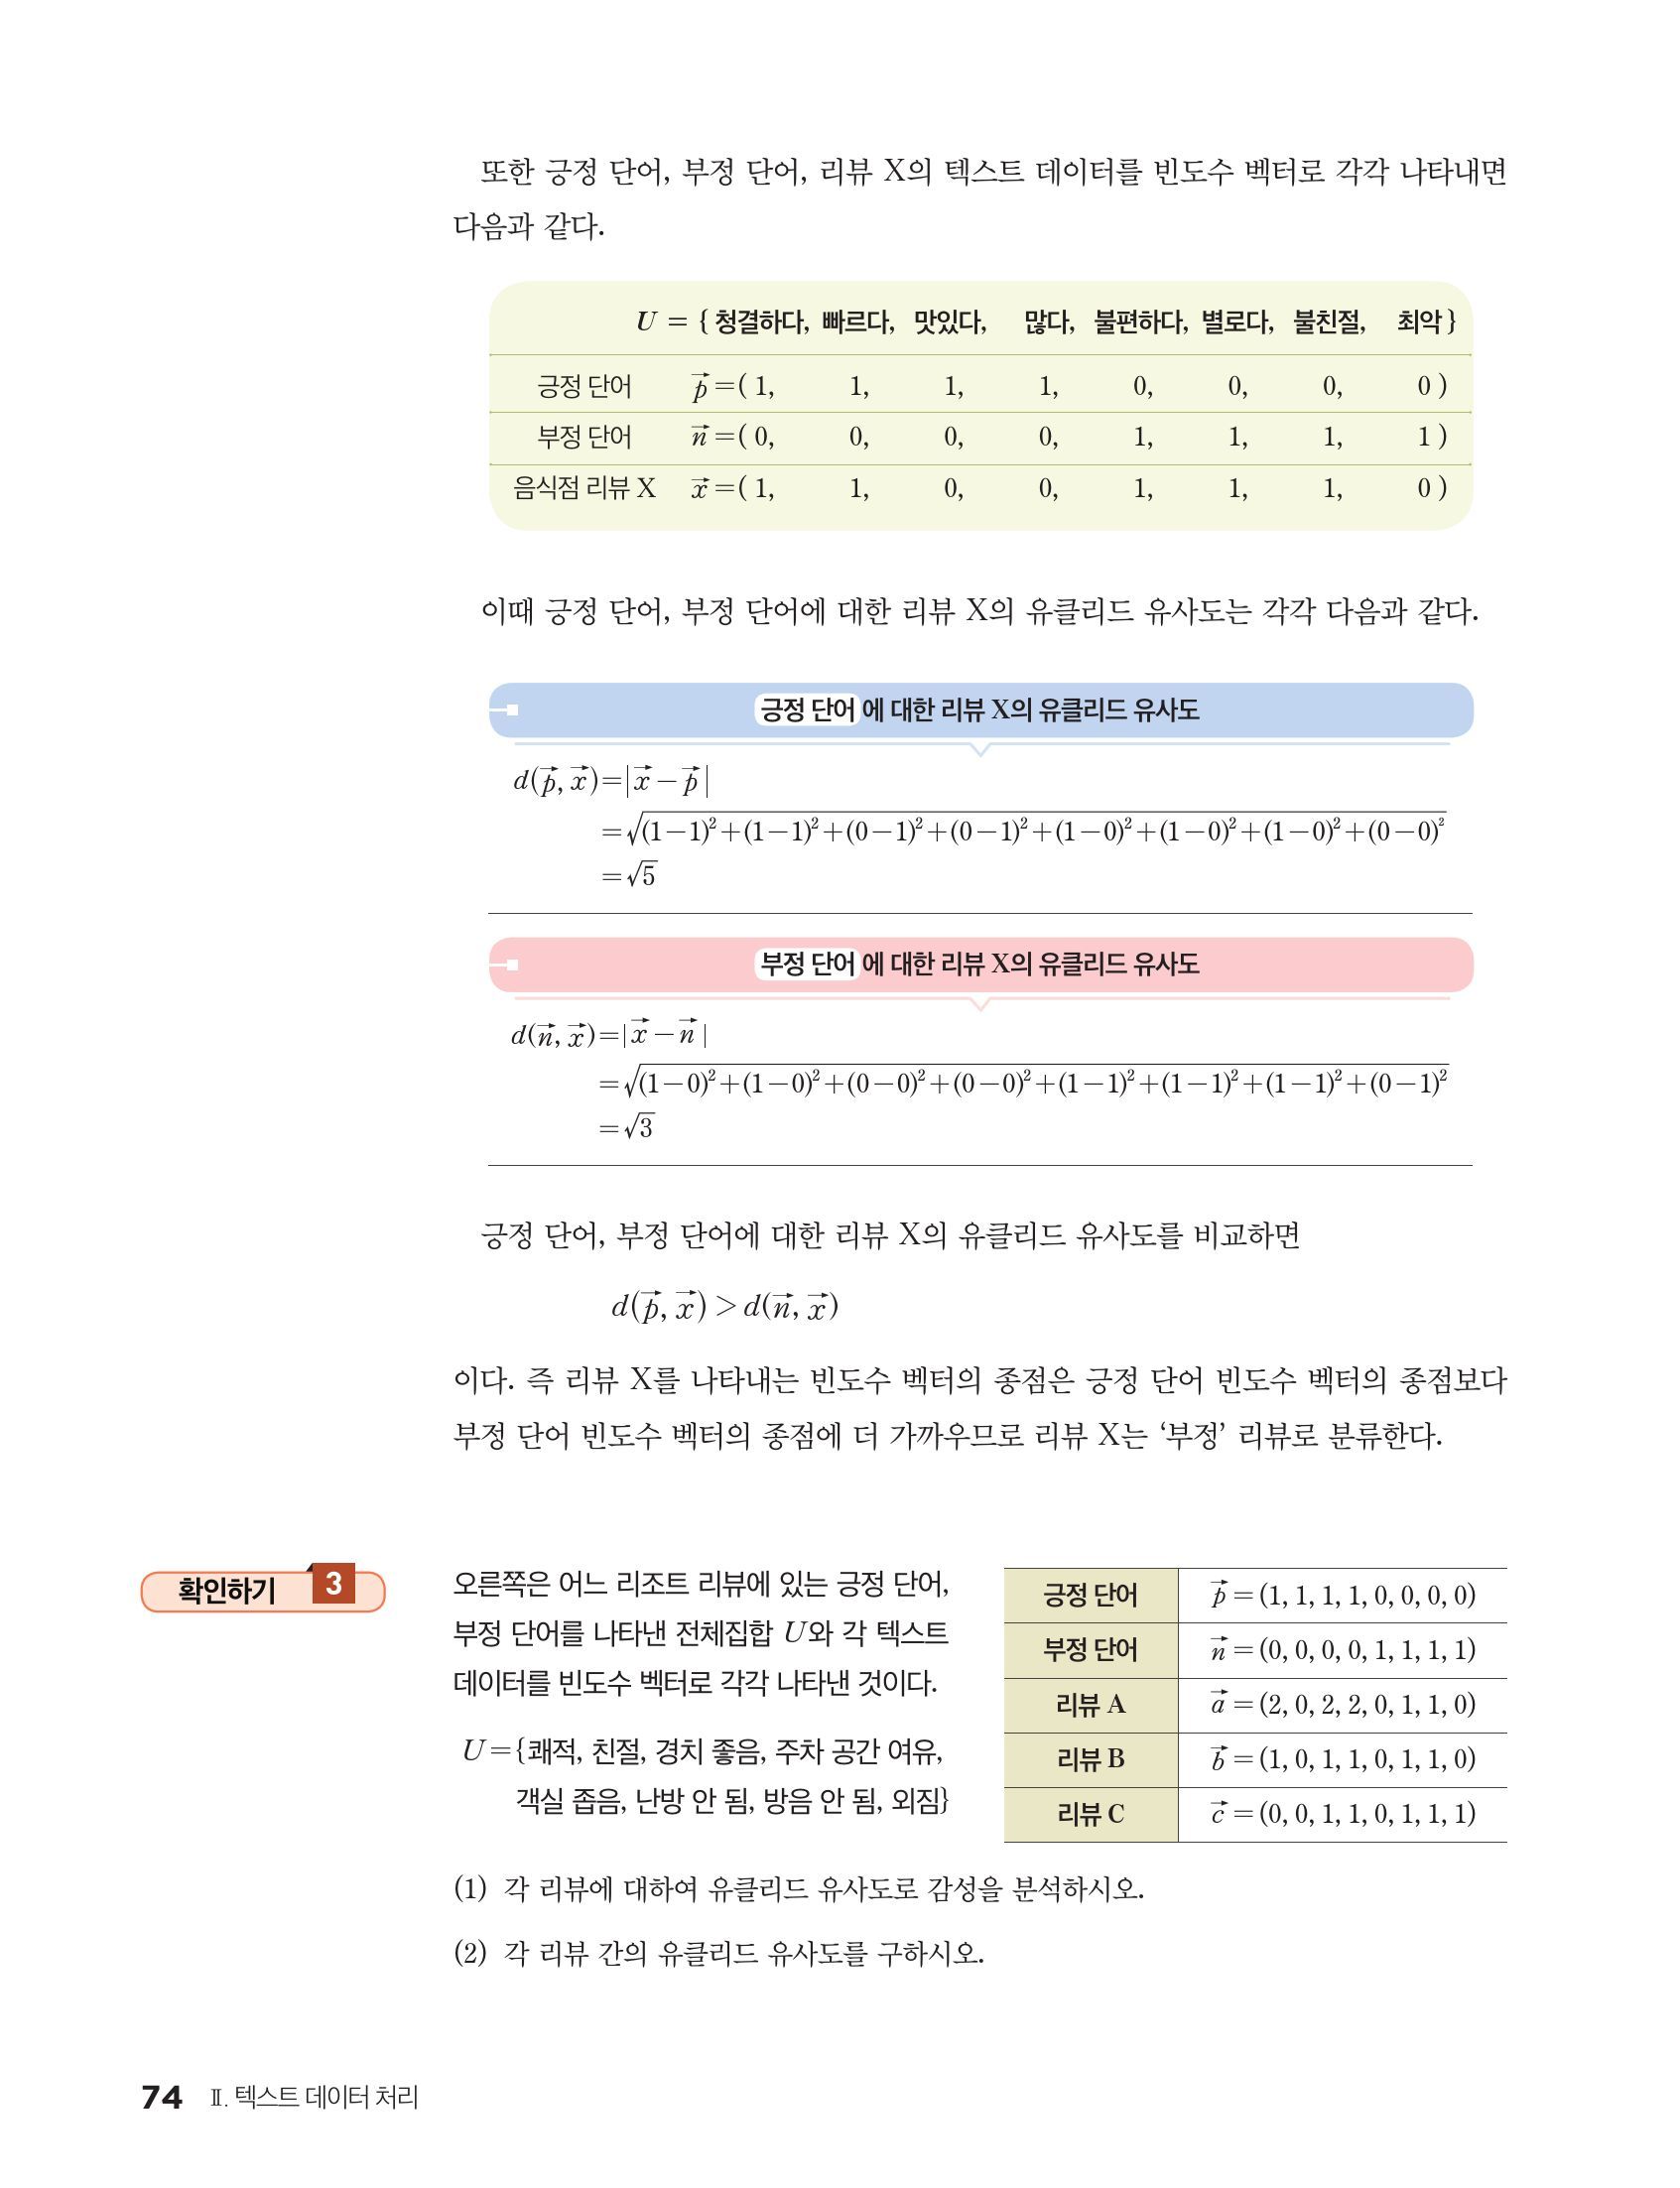
성분이 모두 0인 벡터를 영벡터라고 한다. 영벡터가 아닌 두 빈도수 벡터의 코사인 유사도는 다음과 같다. 분자는 같은 자리의 수끼리 곱해 더한 값이고, 분모는 각 벡터의 제곱합의 제곱근을 곱한 값이다.
교과서는 분모의 를 벡터 의 크기라 부르고, 코사인 유사도를 로 쓴다. 값이 1에 가까울수록 비슷하며, 같은 벡터끼리는 이다.
그림 2의 줄에서 A와 B의 곱의 합은 2다. 줄과 줄의 합은 6과 3이다.
B와 C는 곱의 합이 이고 제곱합은 3과 5이므로 이다. A와 C는 두 문서에 함께 나온 단어가 없어 모든 곱이 0이다. 그래서 분자가 0이고 코사인 유사도도 0이다.
텍스트 유사도에서 영벡터의 코사인 유사도를 0으로 계산해도 될까?
영벡터가 포함된 코사인 유사도는 원래 정의되지 않는다. 식 (4)의 분모에서 영벡터의 크기가 0이라 나눌 수 없고, 화살표도 점 하나라 방향이 없다. 0점으로 대신 처리하는 것은 추가 운영 규칙이므로 원래 공식의 결과와 구별해 기록한다.
코사인 유사도는 왜 ‘코사인’이라고 부를까?
성분이 두 개일 때 식 (4)의 값은 원점에서 그은 두 화살표 사이 각 의 코사인과 같기 때문이다. 그림 3의 , 은 이고, 사이각은 약 다. 성분이 많아져도 같은 식으로 방향의 차이를 잰다.
교과서도 코사인 유사도를 두 벡터의 방향이 비슷한 정도로 설명한다. 각이 에 가까울수록 값은 1에, 에 가까울수록 0에 가깝다. 횟수에는 음수가 없어 분자가 0 이상이므로 빈도수 벡터의 코사인 유사도는 0 이상이고, 각은 를 넘지 않는다. 값이 1을 넘지 않는 이유는 아래 접은 글에 있다. 공통 단어가 하나도 없는 A와 C가 값 0, 즉 직각인 경우다.

figures/scaling_direction.py그림 3에서 를 2배 한 는 같은 방향을 가리킨다. 횟수 배열 전체를 같은 양수배로 늘리면 식 (4)의 분자와 분모에 같은 수가 곱해져 약분되므로, 코사인 유사도는 그대로다. 반면 두 끝점 사이 거리는 로 0이 아니다. 거리로는 가, 코사인으로는 가 와 더 가깝다.
코사인법칙으로 확인하는 각과 값의 범위
를 벡터의 크기라 하자. 원점과 두 끝점이 만드는 삼각형에서 두 변은 이고, 끼인각 의 맞은편 변은 끝점 거리 다. 코사인법칙에 따라 이다.
한편 를 전개하면 이다. 두 식을 비교하면 로 식 (4)와 같다. 그림 3에서는 이다.
성분이 많을 때 범위는 다음처럼 확인한다. 각 벡터를 자기 크기로 나눈 성분을 라 하면 각각의 제곱합은 1이고, 코사인 유사도는 이다. 음이 아닌 성분끼리 곱하므로 이 합은 0 이상이다. 또 을 전개하면 이고 이 값은 0 이상이므로 이다.
일 때 를 로 바꾸면 식 (4)의 분자와 분모의 첫 제곱근에 모두 가 곱해져 약분된다. 영벡터를 만들지 않도록 은 제외한다.
텍스트 유사도로 유클리드 거리와 코사인 유사도 중 무엇을 써야 할까?
텍스트 유사도를 잴 때 문서 길이가 크게 다르면 코사인 유사도가, 횟수 자체의 차이가 중요하면 유클리드 거리가 알맞다. A를 그대로 두 번 이어 쓴 은 B와의 거리가 에서 로 커지지만 코사인 유사도는 약 0.471 그대로다. 목적을 먼저 정하고 기준을 고른다.
텍스트 유사도의 기준이 다르면 가장 비슷한 문서가 바뀔까?
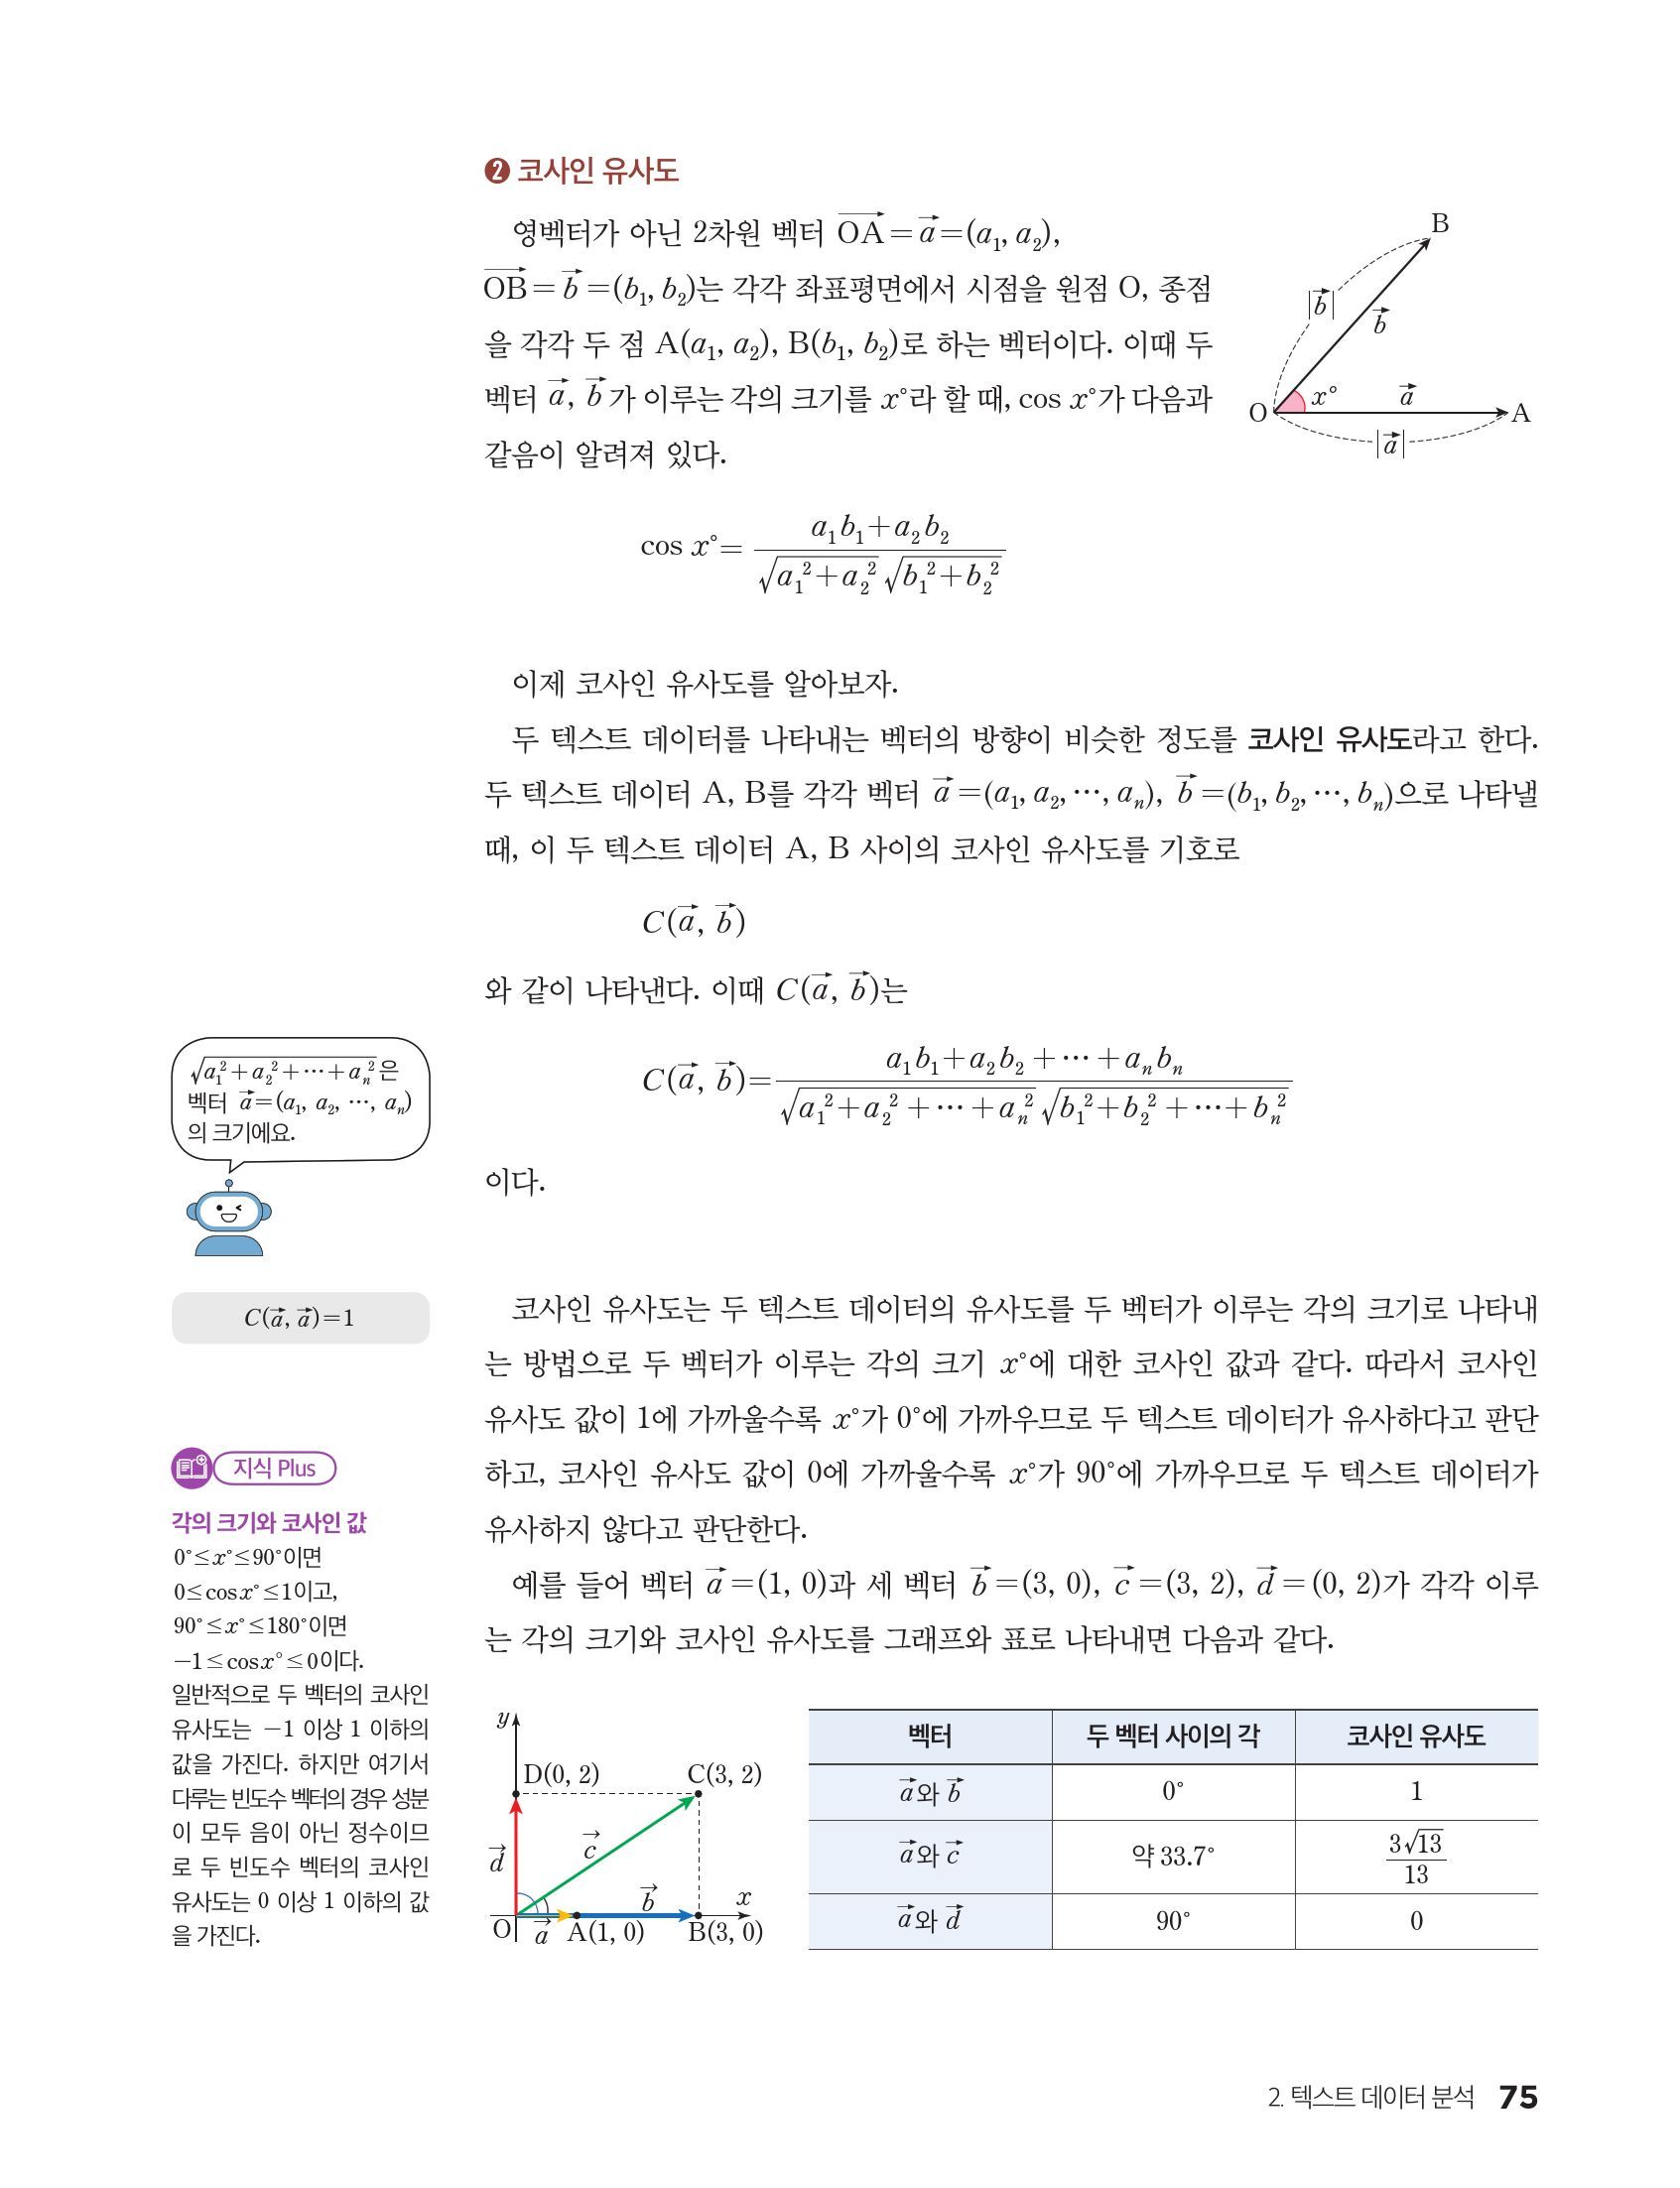
바뀔 수 있다. 세 문서의 모든 쌍을 계산하면 B와 가장 비슷한 문서는 자카드 유사도로는 A, 유클리드 유사도와 코사인 유사도로는 C다.
| 문서 쌍 | 자카드: 클수록 비슷함 | 거리: 작을수록 가까움 | 코사인: 클수록 비슷함 |
|---|---|---|---|
| A와 B | 약 0.471 | ||
| A와 C | 0 | 0 | |
| B와 C | 2 | 약 0.516 |
A의 짝으로는 세 기준 모두 B를 고르고, C의 짝으로도 모두 B를 고른다. 순위가 갈리는 것은 B를 기준으로 할 때뿐이다(그림 4). 계산이 틀려서가 아니라 단어 종류의 겹침과 횟수 배열의 비교가 다른 질문이기 때문이다.
B와 A는 단어 종류가 두 개 겹치지만, A에는 B에 없는 ‘숲’이 두 번 나온다. 이 차이 2가 거리의 제곱합에 4를 더하고, 코사인의 분모에서 A의 제곱합을 6으로 키운다. B와 C는 겹치는 종류가 하나뿐이지만 C에 ‘바다’가 두 번 나와 곱의 합이 A와 같은 2가 된다.

figures/similarity_comparison.py텍스트 유사도는 자카드가 단어 종류의 겹침을, 유클리드 유사도가 횟수 차이를, 코사인 유사도가 횟수 배열의 방향을 재므로 기준마다 가장 비슷한 문서가 달라질 수 있다.
텍스트 유사도로 리뷰의 감성을 분류할 수 있을까?
분류할 수 있다. 긍정 단어 집합과 부정 단어 집합을 기준으로 두고, 리뷰가 어느 쪽과 더 비슷한지 비교하면 된다. 교과서도 자카드·유클리드 유사도로 음식점 리뷰를 긍정과 부정으로 나누는 예를 다룬다.
학습용으로 긍정 단어 와 부정 단어 를 정하자. 어떤 리뷰에서 감성 단어만 뽑은 집합이 라 하면 식 (2)로 다음을 얻는다.
리뷰가 긍정 단어와 더 많이 겹치므로 긍정으로 분류한다. 여섯 단어를 좋다·친절하다·깨끗하다·느리다·불편하다·시끄럽다() 순서로 놓은 0·1 벡터 로 계산해도 결론이 같다. 거리는 , 이고, 코사인 유사도는 과 이다.

figures/sentiment_similarity.py두 값이 같으면 어느 쪽으로도 정할 수 없으므로, 판단 보류 같은 동점 규칙을 계산 전에 정해 둔다. 단어마다 점수를 매겨 더하는 다른 방법은 사전 기반 감성 분석에서 다룬다. 검색도 같은 원리다. 검색어를 짧은 문서로 보고 유사도가 큰 문서부터 보여 주면 된다.
텍스트 유사도의 흔한 오해
- 자카드 유사도가 더 크면 코사인 유사도도 반드시 더 크다. — B와 비교하면 자카드는 A가 로 C의 보다 크지만, 코사인 유사도는 A가 약 0.471로 C의 약 0.516보다 작다.
- 코사인 유사도가 1이면 두 문장의 정보가 모두 같다. — 그림 3의 와 처럼 횟수가 같은 양수배여도 1이다. ‘민수 영희 좋아하다’와 ‘영희 민수 좋아하다’도 자카드·코사인 유사도가 모두 1이지만 누가 누구를 좋아하는지는 다르다.
- 뜻이 비슷한 문서는 유사도도 높다. — ‘좋다’ 한 단어 문서와 ‘훌륭하다’ 한 단어 문서는 공통 단어가 없어 자카드·코사인 유사도가 모두 0이다. 이 기준들은 표기가 같은 단어만 같은 단어로 센다.
직접 해보기
각 문항의 벡터는 같은 어휘 순서의 횟수다.
- , 의 자카드 유사도를 식 (1)과 식 (2)로 각각 구하자.
- , 의 유클리드 유사도와 코사인 유사도를 구하자.
- 검색어 ‘숲 좋다’를 이 글의 어휘 순서로 나타내고, 문서 A·B·C를 코사인 유사도가 큰 순서로 늘어놓자. 유클리드 유사도로도 순서가 같은지 확인하자.
- TF-IDF의 교과 모형처럼 IDF 를 곱하면 A와 B는 , 이 된다. 두 배열의 코사인 유사도를 구하고, 횟수로 구한 약 0.471과 비교하자.
- 빈 집합과 비어 있지 않은 집합의 자카드 유사도, 영벡터와 0이 아닌 벡터의 코사인 유사도를 각각 구할 수 있는지 판단하자.
답과 풀이
- 교집합은 {책}, 합집합은 {책, 음악, 산책, 여행}이므로 식 (1)로 이다. 식 (2)로도 이다.
- 차이는 이므로 거리는 다. 곱의 합은 1, 두 제곱합은 각각 5이므로 코사인 유사도는 다.
- 검색어는 이다. 코사인 유사도는 A가 , B가 , C가 0이므로 A, B, C 순서다. 거리는 , , 로 순서가 같다.
- 두 배열은 각각 과 을 배 한 것이다. 양수배는 코사인 유사도를 바꾸지 않으므로 다. B와 겹치지 않는 ‘숲’의 IDF가 3으로 공통 단어의 보다 커서 0.471보다 작아졌다.
- 빈 집합과 비어 있지 않은 집합의 자카드 유사도는 분모가 양수이고 분자가 0이므로 0이다. 영벡터가 포함된 코사인 유사도는 분모가 0이어서 정의되지 않는다.
더 읽기
- 교육부, 2022 개정 수학과 교육과정 — 인공지능 수학 [12인수02-03]과 해설. 텍스트의 수학적 분석을 다루고 코사인 유사도에 내적 용어·기호를 사용하지 않는 범위다.
- 씨마스, 고등학교 인공지능 수학 70쪽 — 윤상운 외, 2022 개정판. 유사도의 뜻, 자카드 유사도의 두 꼴과 범위, 리뷰 감성을 자카드 유사도로 분류하는 예가 있다.
- 씨마스, 73쪽 — 유클리드 유사도를 위치벡터의 종점 사이 거리로 정의하고 0에 가까울수록 유사하다고 보는 관례를 확인할 수 있다.
- 씨마스, 74쪽 — 긍정·부정 단어와 리뷰를 0·1 빈도수 벡터로 나타내 유클리드 유사도로 분류하는 예와 확인 문제다.
- 씨마스, 75쪽 — 코사인 유사도를 두 벡터가 이루는 각의 코사인으로 설명하고, 빈도수 벡터에서 0 이상 1 이하임을 밝힌다.
영상 노트
- 00:00 B와 가장 비슷한 문서가 기준마다 다른가라는 질문 던지기
- 00:40 그림 1의 벤 다이어그램으로 식 (1)·(2)의 자카드 유사도 세기
- 02:00 그림 2의 표를 한 줄씩 채워 식 (3)의 거리와 식 (4)의 코사인 유사도 계산하기
- 04:00 그림 3에서 각 θ와 끝점 거리 비교, 코사인법칙 유도 판서
- 05:30 세 쌍의 표와 그림 4로 순위 역전의 이유 설명하기
- 06:30 그림 5로 리뷰의 감성을 유사도로 분류하기
- 07:30 흔한 오해 세 가지와 직접 해보기 3·4번 풀이
지도에서의 위치
- 2026-11-16 · 에이전트 초안 — 정의·계산·실패 사례·새 연습 작성
- 2026-11-17 · 전수 검수 반영 — 교과서 자카드 둘째 꼴·기준값·각과 코사인 관계·감성 분류 활용 보강, 세 쌍 비교표·질의 검색·TF-IDF 연습 추가, 비교 그림 색 의미 정리 (에이전트 수정, 그림 2→5)
- 2026-11-17 · 전수 검수(에이전트 편집·독립 검증) 통과 — 주인 요청으로 완성으로 올림