직관 — 여러 오차를 하나의 점수로 모으기
추세선 후보가 여럿이면 어느 것을 고를지 점수판이 필요하다. 너무 높게 예측한 오차와 너무 낮게 예측한 오차를 그대로 더하면 서로 지워진다. 각 오차를 제곱해 평균 내면 후보 하나에 음수가 아닌 점수 하나를 붙일 수 있다.
그 점수가 이 글의 손실이다. 추세선으로 예측하기의 가상 자료 , 을 그대로 사용한다. 자료는 고정하고 원점을 지나는 직선의 기울기 하나만 바꾼다. AI 모델이 학습한다는 말은 이런 손실이 작아지도록 모수를 고친다는 뜻이다.
손실함수의 입력은 왜 기울기일까?
일변수 제곱 손실은 고정된 자료에 대한 예측 오차의 제곱을 평균 내어, 모수 하나에 대응시키는 함수다. 이 글의 예측식은 이며 손실함수의 입력은 가 아니라 기울기 다. 를 바꾸면 모든 자료의 예측값이 함께 달라진다.
자료가 개이고 일 때, 번째 자료를 라 쓰자. 이 글의 오차는 예측값에서 관측값을 뺀 값이다. 반대로 뺀 오차도 제곱하면 같지만, 한 계산 안에서는 부호의 약속을 유지한다.
| 기호 | 이름 | 원어 | 뜻 |
|---|---|---|---|
| 입력·관측값 | input, observation | 고정된 번째 자료의 두 수 | |
| 자료 수 | sample size | 양의 정수 | |
| 추세선 기울기 | slope parameter | 손실을 비교하면서 바꾸는 유일한 수 | |
| 오차 | prediction error | 예측값 에서 관측값 를 뺀 값 | |
| 평균제곱오차 | mean squared error | 이 글에서 쓰는 손실함수, 줄여서 MSE |
교과서는 오차를 관측값에서 예측값을 뺀 로 쓴다. 부호만 반대이고 제곱하면 같으므로 는 같다. 교과서는 손실함수를 비용함수, 목적함수라고도 부른다.
합 기호는 부터 까지 각 오차 제곱을 더하라는 뜻이다. 이처럼 기울기 하나를 입력으로 삼는 손실을 일변수 제곱손실이라고 부른다. 일반적인 ‘손실함수’에는 다른 정의도 있지만, 여기서는 식 (1)로 고정한다.
그림 1은 오차 를 점과 직선 사이의 세로 선분으로, 오차의 제곱을 그 선분을 한 변으로 하는 정사각형의 넓이로 나타낸다. 손실은 정사각형 넓이의 평균이다. 에서는 넓이 1인 정사각형 두 개라 손실이 1이고, 에서는 넓이 0.16과 0.04의 평균 0.1이다.

figures/residual_squares.py왜 제곱하고 평균 낼까?
제곱은 오차의 방향을 지우고 크기를 남긴다. 0의 제곱만 0이므로 손실은 항상 0 이상이고, 0이 되려면 모든 자료의 오차가 0이어야 한다. 또한 오차의 크기가 1에서 2로 두 배가 되면 제곱은 1에서 4로 네 배가 된다. 이 점수는 큰 오차를 더 무겁게 반영한다.
예를 들어 두 점의 자료에서 이면 오차는 , 이다. 오차를 그냥 더하면 0이지만 두 예측이 모두 틀린 것은 그대로다. 제곱 평균은 로 0이 아니다.
오차의 평균을 라 쓰면 두 점 자료에서 다. 그림 2처럼 이 값은 를 줄일수록 계속 작아져 에서 가 된다. 가장 작은 값을 찾는 기준으로 쓰면 기울기를 한없이 줄이라는 엉뚱한 답이 나온다.

figures/mean_error_vs_mse.py평균을 내는 것은 자료 한 개당 오차 제곱으로 읽기 위해서다. 같은 자료를 두 벌로 반복해 합만 구하면 두 배가 되지만, 평균은 그대로다. 그렇다고 서로 다른 자료 집합의 MSE만 보고 모형을 공정하게 비교할 수 있는 것은 아니다. 모형 비교에서는 같은 평가 자료와 같은 단위를 사용한다.
제곱 손실에서 오차를 절댓값이 아니라 왜 제곱할까?
제곱도 절댓값처럼 오차의 부호를 지우지만, 손실을 기울기의 이차함수로 만들어 완전제곱으로 최소점을 구할 수 있게 한다. 또 큰 오차를 더 무겁게 센다. 오차가 1과 3인 경우와 2와 2인 경우는 절댓값의 합이 4로 같지만, 제곱의 합은 10과 8로 고르게 틀린 쪽이 작다.
두 점의 손실을 이차함수로 만들기
자료 두 개를 식 (1)에 넣으면 각 예측이 , 다. 이 예제에서 이면 오차는 이므로 손실은 1이다. 일반적인 를 남겨 전개하면 다음과 같다.
각 제곱을 풀면 , 다. 같은 차수끼리 더한 뒤 완전제곱을 만들자.
제곱 부분은 음수가 아니고, 에서만 0이다. 따라서 이 자료와 원점 통과 모형에서는 손실의 최솟값이 0.1이며 그때의 기울기는 유일하게 1.6이다. 앞 글에서 Desmos가 낸 기울기 1.6이 왜 최소인지를 이차함수의 성질의 완전제곱으로 설명한 것이다.
| 기울기 | 첫 예측 | 둘째 예측 | 손실 |
|---|---|---|---|
| 1 | 1 | 2 | 1 |
| 1.5 | 1.5 | 3 | 0.125 |
| 1.6 | 1.6 | 3.2 | 0.1 |
| 2 | 2 | 4 | 0.5 |

figures/loss_landscape.py그림 3의 최소점에서도 관측값과 예측값은 다르다. 오차는 , 이고 제곱은 0.16, 0.04다. 평균 을 직접 계산해 검산할 수 있다.
자료가 많아도 세 합만 구하면 손실식이 나온다
자료가 몇 개든 손실식의 계수는 입력의 제곱의 합, 입력과 관측의 곱의 합, 관측의 제곱의 합 세 가지로 정해진다. 각 오차 제곱을 다음처럼 전개해 같은 차수끼리 모으기 때문이다.
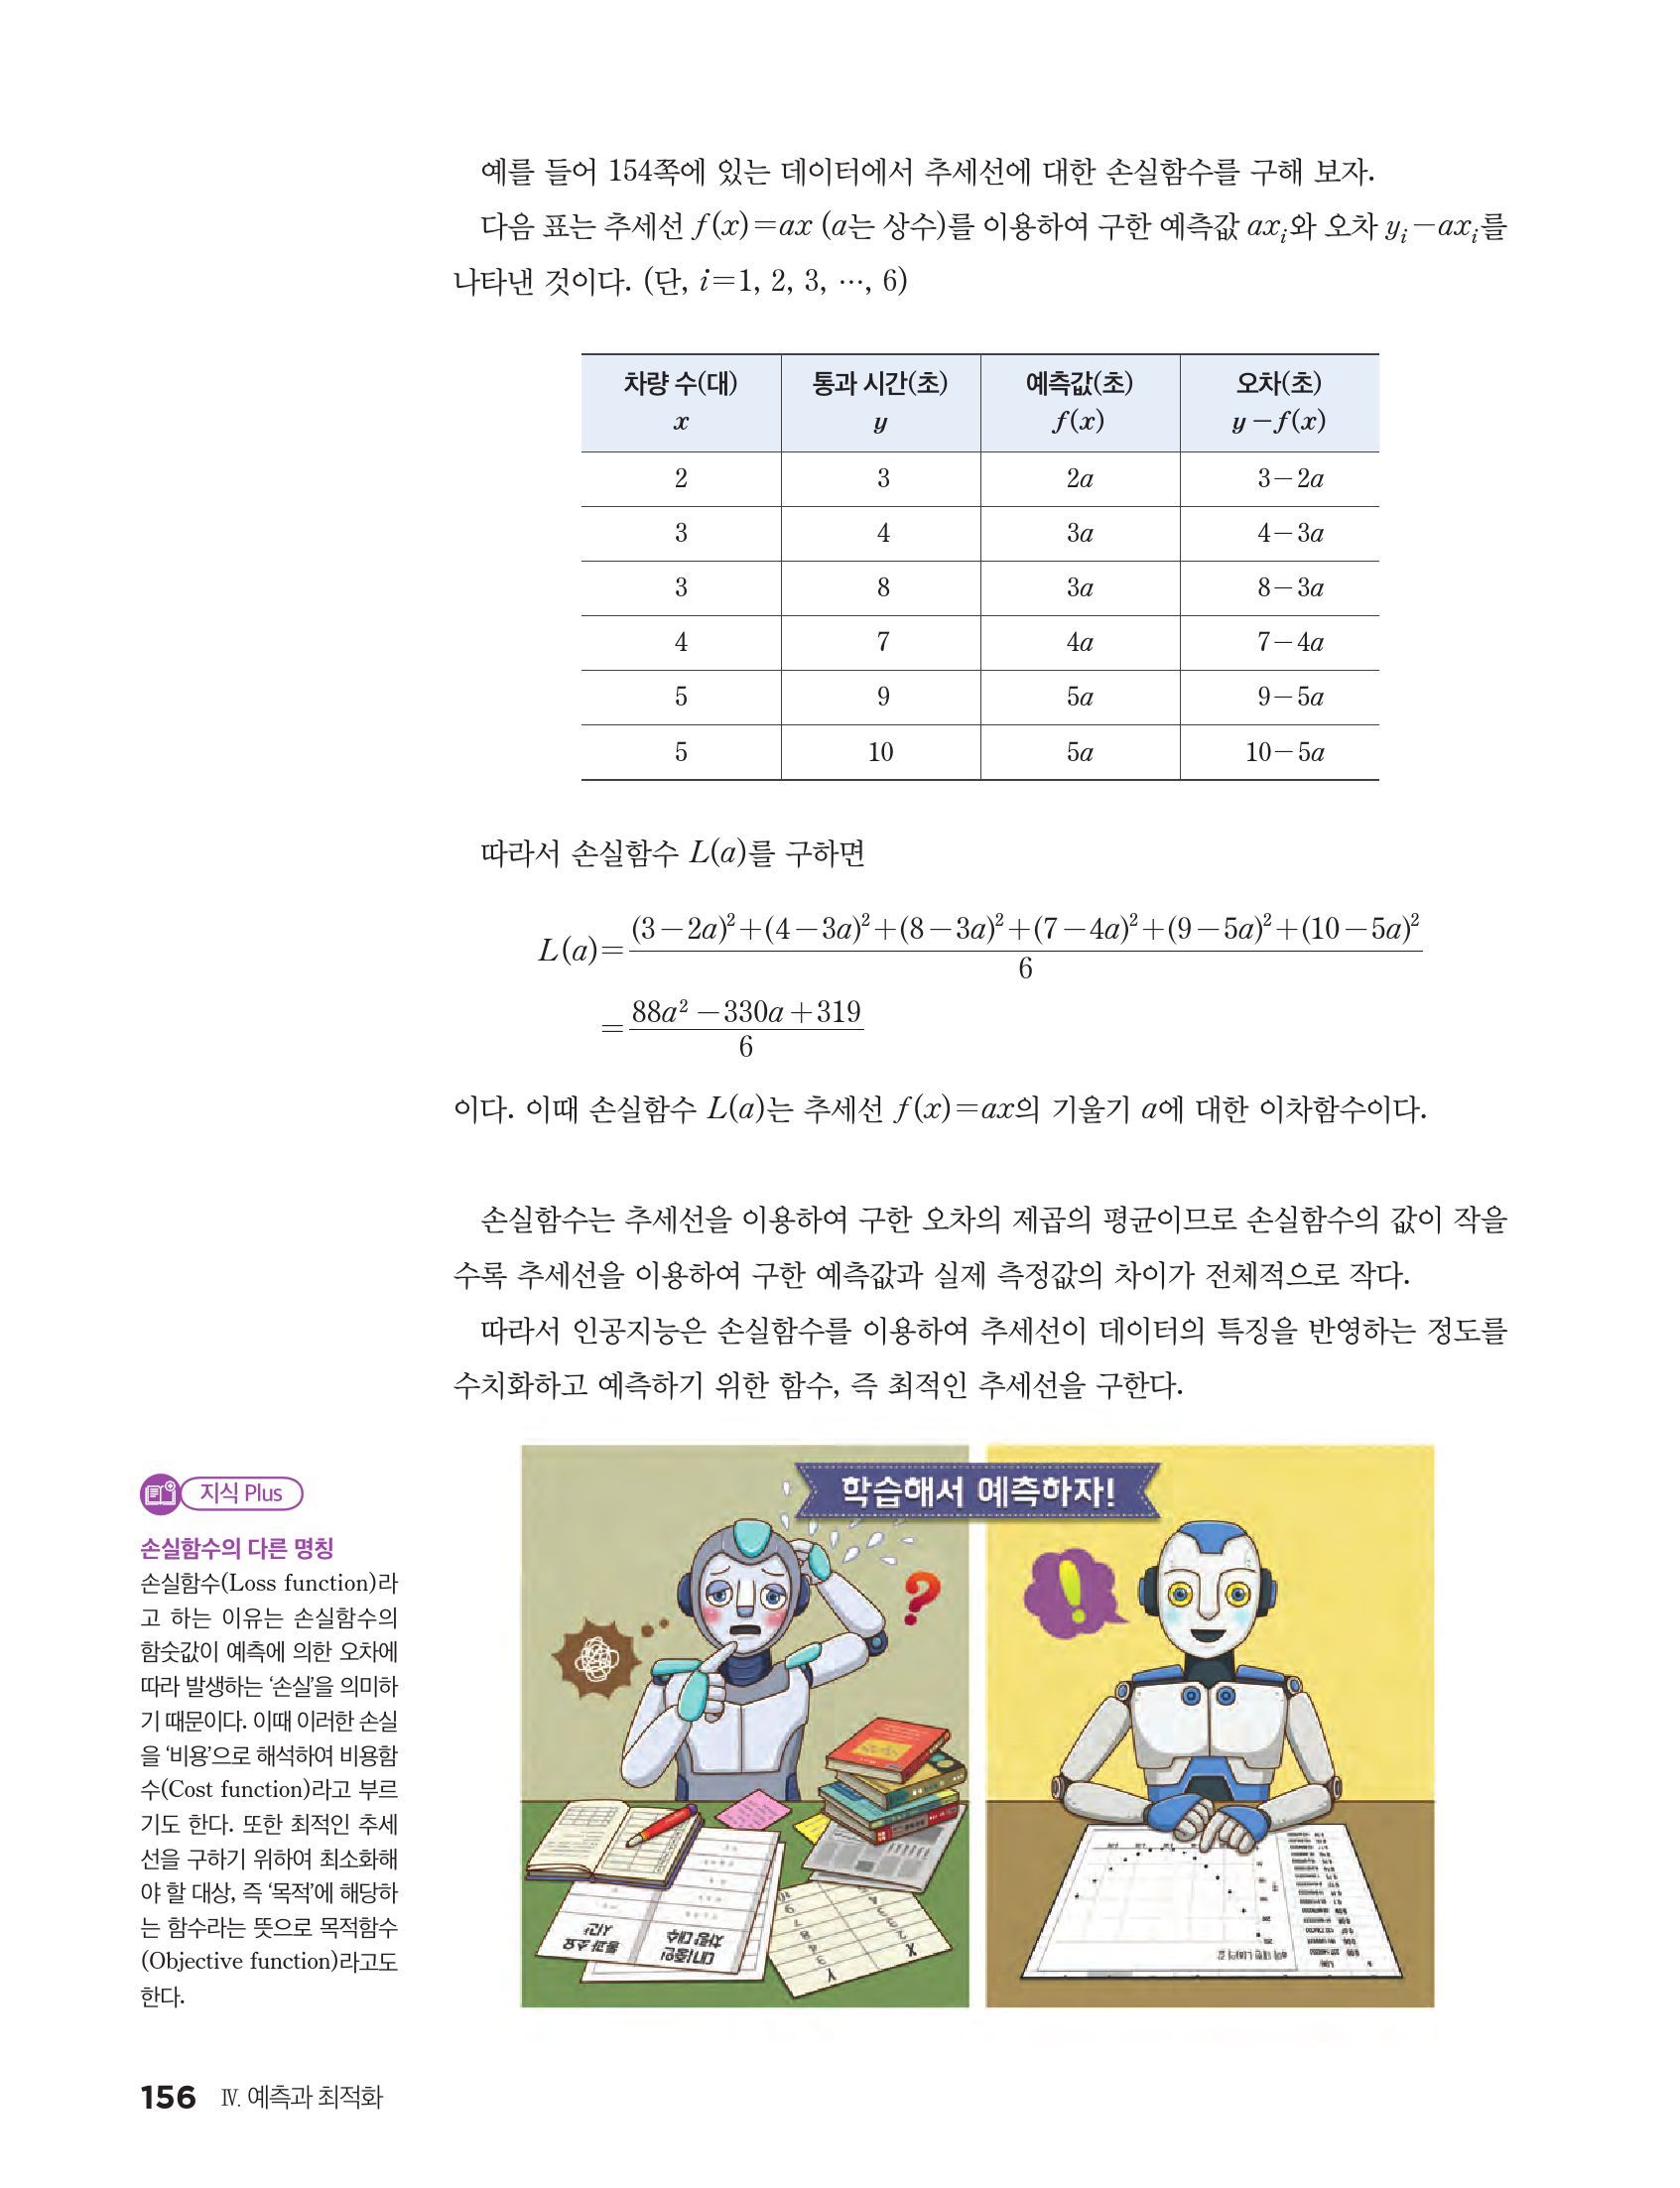
여기서 합은 모두 부터 까지다. 앞 글의 여섯 점 자료(이미지 수 백 장, 처리 시간 초)로 확인하자. 오차 열은 기울기가 일 때의 값이다.
| 오차 | |||||
|---|---|---|---|---|---|
| 1 | 4 | 1 | 4 | 16 | |
| 2 | 5 | 4 | 10 | 25 | |
| 3 | 7 | 9 | 21 | 49 | |
| 4 | 9 | 16 | 36 | 81 | |
| 5 | 9 | 25 | 45 | 81 | |
| 6 | 11 | 36 | 66 | 121 | |
| 합 | 91 | 182 | 373 |
세 합을 식 (5)에 넣으면 다음과 같다. 의 계수는 다.
식 (6)의 분자에서 이므로 분자는 다.
이 자료의 최소점은 , 최솟값은 1.5다. 앞 글에서 Desmos의 y_1~ax_1이 같은 자료에 낸 기울기 2와 같다. 의 오차는 이고, 제곱의 합 9를 6으로 나눠도 1.5다.
식 (5)에서 이면 같은 방법으로 완전제곱을 만들 수 있다. 최소가 되는 기울기는 다음과 같다.
두 점 자료에서는 , 여섯 점 자료에서는 다.
식 (8)의 유도
, , 로 두고 이라 하자. 식 (5)의 분자는 다음처럼 완전제곱으로 바뀐다.
이므로 제곱 부분은 에서만 0이다. 최솟값은 이며, 두 점 자료에서는 으로 식 (3)과 같다.
모든 자료에서 이차함수가 될까?
원점 통과 모형의 MSE를 전개했을 때 의 계수는 식 (5)의 , 즉 입력값 제곱의 평균이다. 입력값 중 하나라도 0이 아니면 이 계수는 양수이므로 손실은 아래로 볼록한 이차함수다. 이차함수의 성질에 따라 유일한 최소점이 있다.
반대로 모든 입력이 0이면 예측값도 항상 0이다. 예를 들어 자료 , 에서는 기울기를 아무리 바꿔도 손실은 다. 이 경우 손실은 상수이며, 식 (8)의 분모도 0이 되어 자료만으로 최적 기울기 하나를 구별할 수 없다.
원점 통과 모형의 제곱 손실은 고정된 양의 개수 자료에서 예측 오차의 제곱을 평균 낸 값이다. 입력 중 하나라도 0이 아니면 기울기 하나에 대한 이차함수로서 유일한 최소점이 있다.
손실이 최소이면 모든 자료를 정확히 맞힐까?
손실 최소는 정해진 모형 안에서 점수가 가장 작다는 뜻이며 손실 0을 뜻하지 않는다. 이 글의 최소 손실은 0.1이다. 두 점을 원점 통과 직선 하나로 동시에 맞힐 수 없어서 오차가 남는다.
관측값의 단위를 바꾸면 제곱 손실도 바뀔까?
관측값의 단위를 바꾸면 제곱 손실의 값도 바뀐다. 미터를 센티미터로 바꾸면 오차의 수치가 100배가 되어 제곱오차는 10000배가 된다. 예를 들어 오차 0.2 m는 20 cm이며 제곱은 각각 0.04와 400이다. 손실 숫자를 비교할 때는 자료의 단위부터 맞춘다.
오차 제곱의 합과 평균은 무엇이 같고 무엇이 다를까?
오차 제곱의 합 와 평균 는 최소가 되는 기울기가 같고, 값과 그래프의 가파름은 배 다르다. 두 점 자료에서 일 때 합은 0.2, 평균은 0.1이다.
평균은 합을 양의 상수 으로 나눈 것이라, 어느 기울기의 손실이 더 작은지의 순서가 그대로 유지된다. 그림 4에서 는 를 세로로 두 배 늘린 곡선이고, 에서도 2와 1로 두 배다.

figures/sse_vs_mse.py다만 곡선이 두 배 가팔라지므로, 손실의 기울기를 따라 모수를 고치는 일변수 경사하강법에서는 같은 학습률이어도 한 번에 움직이는 거리가 달라질 수 있다. 어느 쪽을 쓰는지 정해 두고 끝까지 같은 손실을 쓴다.
제곱 손실에서 흔한 오해
- 손실 그래프의 가로축을 옮기면 새 자료를 예측한다 — 그림 3의 가로축은 다. 새로운 입력 에 대입하는 추세선 그래프와 역할이 다르다.
- 손실이 작으면 아직 보지 않은 자료에서도 반드시 좋다 — 식 (3)은 주어진 두 점에서 얻은 결론이다. 새로운 자료의 성능은 별도 관측값으로 확인한다.
- 최소 손실의 기울기는 각 점의 기울기 y/x를 평균 낸 값이다 — 두 점 자료에서 는 2와 1.5이고 평균은 1.75지만 최소점은 1.6이다. 식 (8)은 입력이 큰 점에 만큼 비중을 더 둔 평균 이다.
직접 해보기
- 새 자료 , 에서 의 손실을 구하고 최솟값을 설명하라.
- 관측값이 5, 7이고 어떤 모형의 예측이 4, 9다. 오차 두 개와 MSE를 구하라.
- 두 자료에서 오차 제곱의 합이 10이다. MSE는 얼마인가? 같은 두 자료를 한 번 더 복사한 네 자료의 MSE도 구하라.
- 새 자료 , 에서 의 손실은 기울기에 따라 달라지는가?
- 새 자료 , , 로 세 합을 구해 를 전개하고, 완전제곱으로 최소점과 최솟값을 구하라.
답과 풀이
- 다. 각각 2.5, 0, 2.5이며 모든 실수 기울기 중 에서만 0으로 최소다.
- 오차는 , 다. MSE는 다.
- 처음은 다. 복사 뒤에는 합이 20, 개수가 4여서 로 같다.
- 두 예측 모두 0이다. 손실은 로 일정하다. 이 자료로 기울기 하나를 선택할 수 없다.
- , , 다. 이므로 에서 최솟값 1이다. 검산하면 의 오차는 이고 제곱의 평균이 1이다.
다음 손실함수의 기울기는 최소점을 바로 풀어 쓰는 대신, 현재 위치에서 손실이 어느 쪽으로 변하는지 읽는다.
더 읽기
- 교육부, 2022 개정 교육과정 고시 — 별책8 [12인수04-03]의 에 대한 일변수 손실 범위를 따른다.
- 씨마스, 인공지능 수학 156쪽 — 원점 통과 예측의 오차 제곱 평균이 기울기의 이차함수가 되는 전개와 손실함수의 다른 이름을 실제 면에서 읽었다. 교과서는 오차를 관측값−예측값으로 쓰며, 이 글은 다른 자료로 계산했다.
- Google, Linear regression: Loss — 제곱오차 합과 평균의 정의를 참고했다. 모든 손실함수가 MSE라는 뜻으로 범위를 넓히지 않는다.
영상 노트
- 00:00 반대 부호의 오차가 지워지는 문제
- 00:50 식 (1) — 자료는 고정하고 기울기만 바꾸기, 교과서의 오차 부호
- 01:50 그림 1 — 오차 제곱을 정사각형 넓이로
- 02:40 그림 2 — 오차의 평균은 왜 기준이 못 되나
- 03:40 식 (2)에서 식 (3)으로 전개, 그림 3 — 최소 손실 0.1
- 05:30 여섯 점 표 → 식 (4)~(7) → 최소점 2
- 07:30 식 (8)과 모든 입력이 0인 경계
- 08:30 그림 4 — 합과 평균의 최소점은 같다
- 09:30 새 연습
지도에서의 위치
- 2026-11-16 · 예측식의 기울기와 손실함수의 기울기를 질문 답에서 구별
- 2026-11-16 · 에이전트 초안 — 조건·계산·가상 자료와 새 연습 작성
- 2026-11-17 · 전수 검수 반영 — 교과서의 오차 부호(관측값−예측값)·다른 이름과 다리, 오차 제곱을 넓이로 보는 그림, 오차 평균이 상쇄되는 반례 그림, 절댓값 대신 제곱하는 이유 질문, 여섯 점 자료의 표 → 세 합 → 완전제곱 대표 유형과 일반 최소점, 합과 평균의 비교 절, 단위 질문 표현 바로잡기, 비중 평균 오해, 해보기 5문항 (에이전트 수정, 그림 1→4)
- 2026-11-17 · 전수 검수(에이전트 편집·독립 검증) 통과 — 주인 요청으로 완성으로 올림