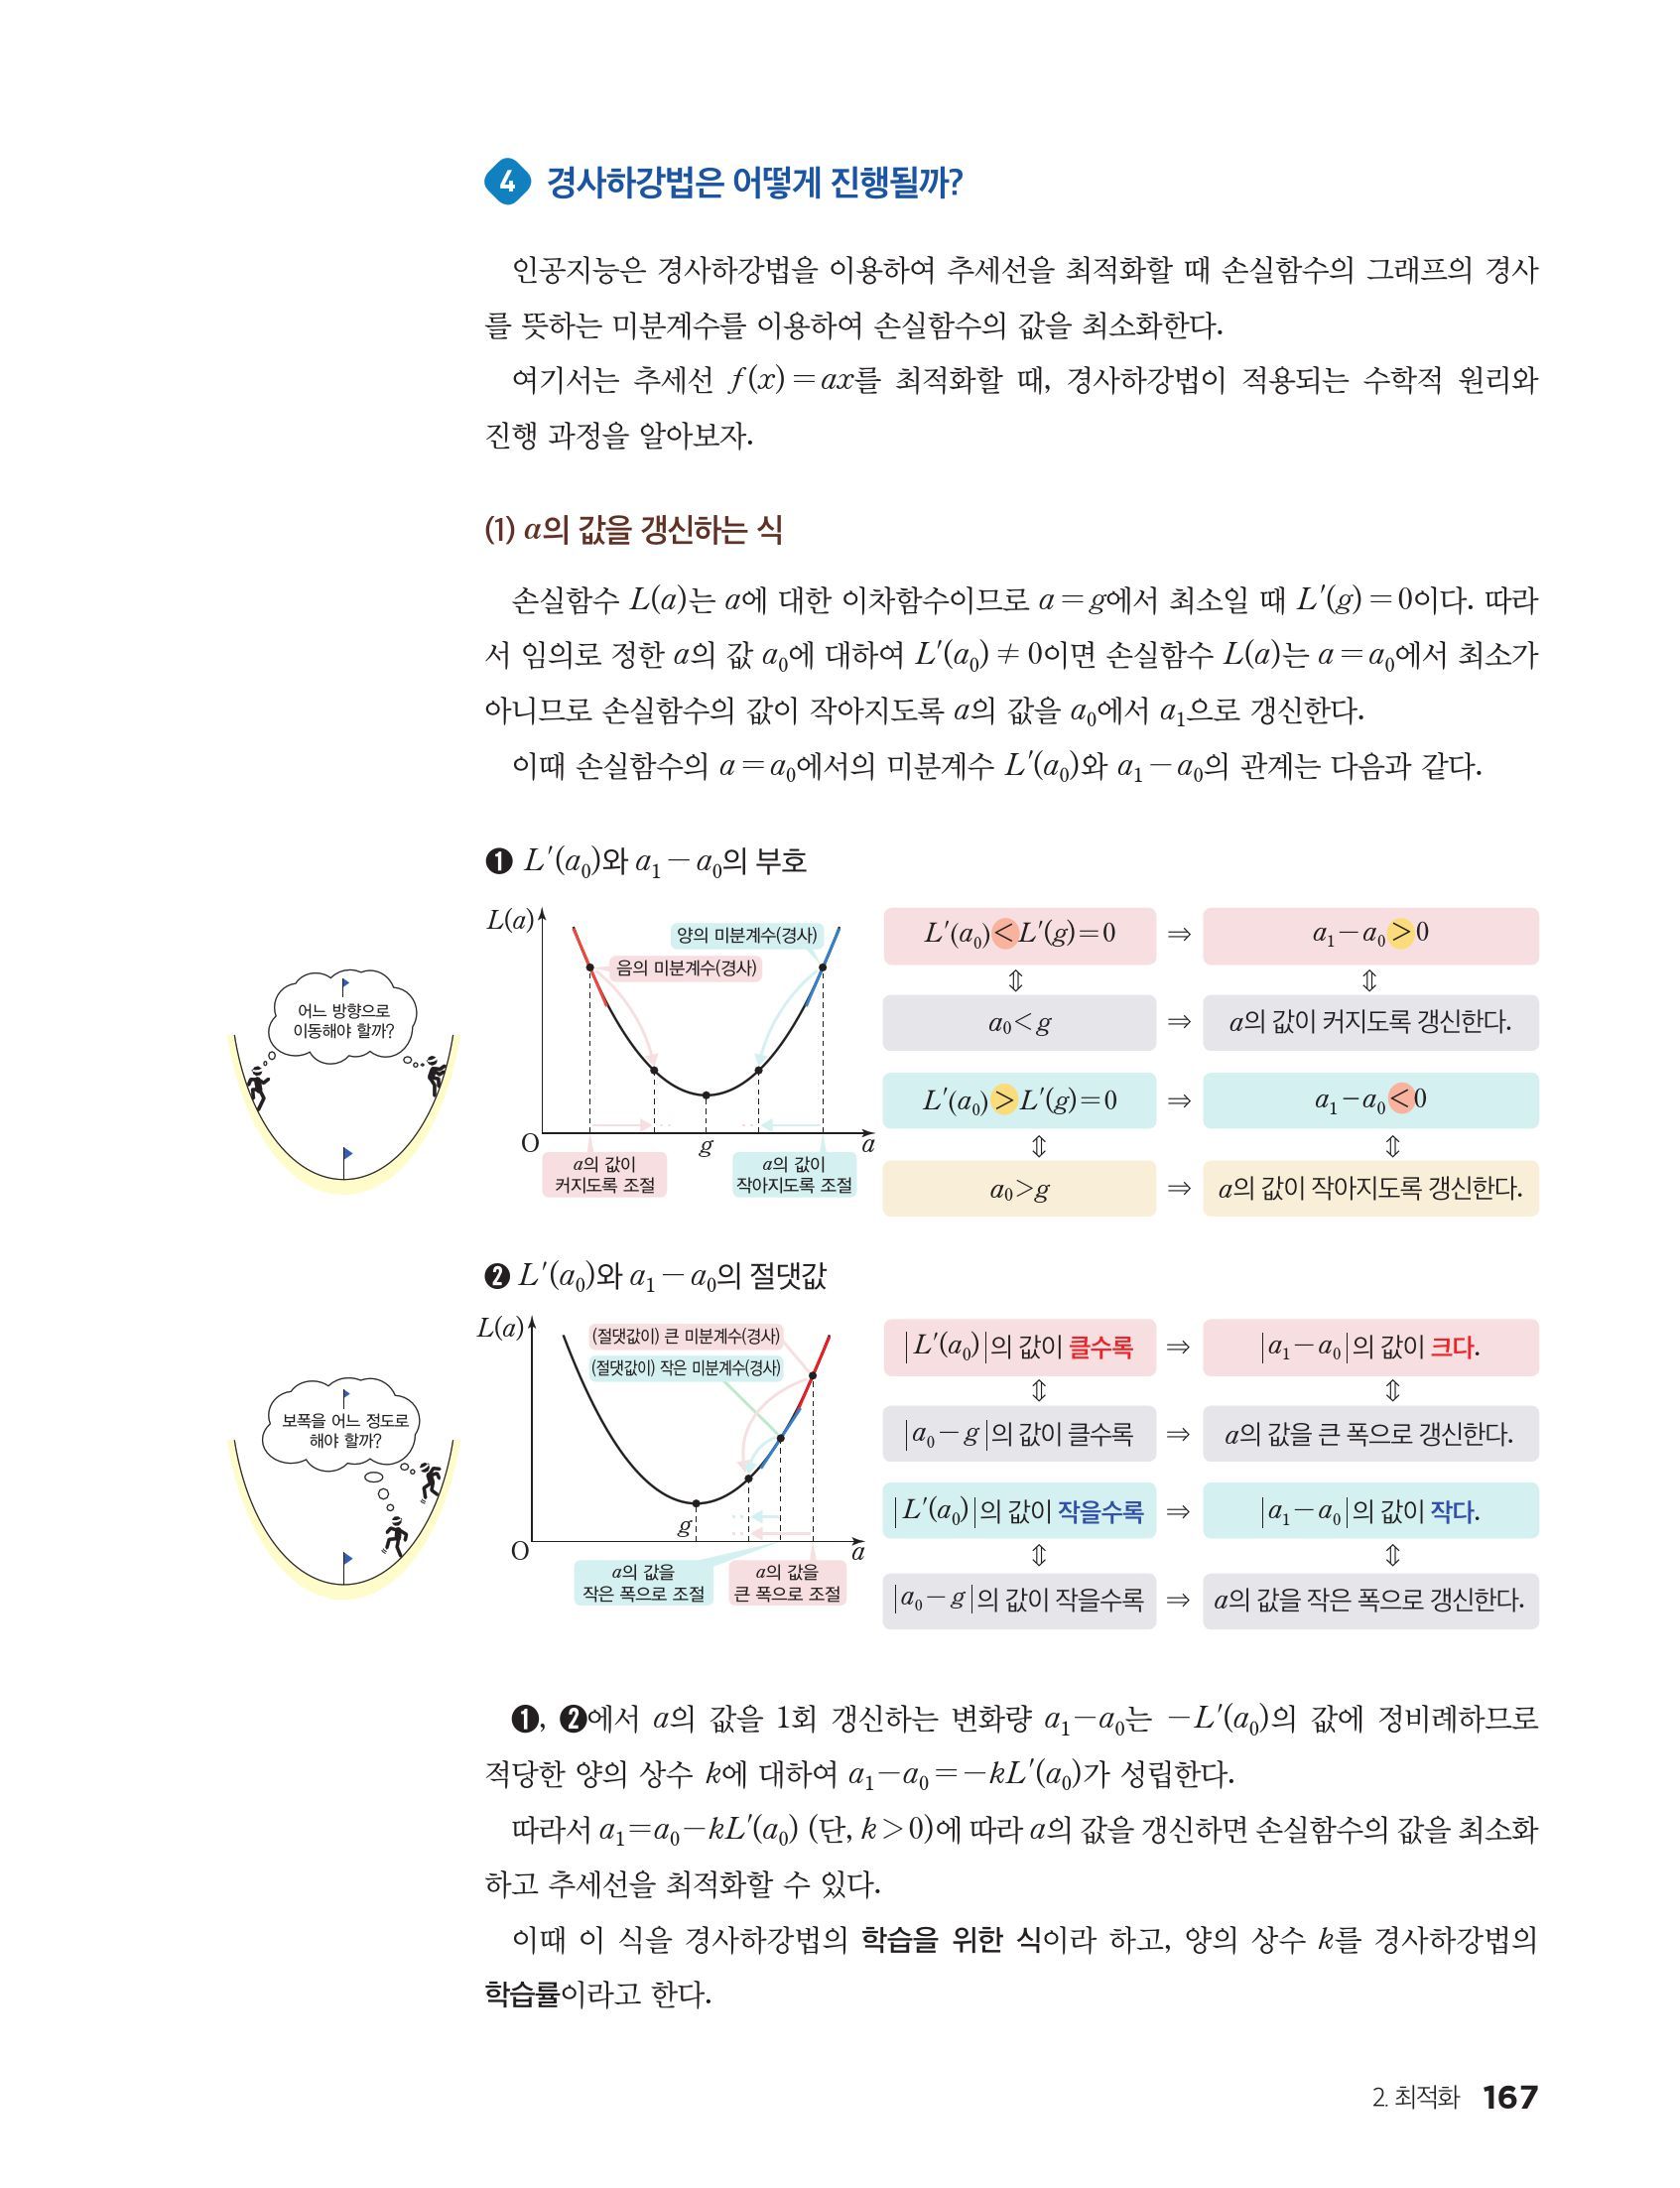
직관 — 비탈의 반대 방향으로 조금씩 움직이기
손실 그래프의 현재 위치에서 비탈이 오른쪽으로 올라가면 왼쪽으로, 오른쪽으로 내려가면 오른쪽으로 움직인다. 한 번에 움직일 크기는 비탈의 가파름과 정해 둔 배율로 결정한다. 움직인 뒤 새 위치에서 비탈을 다시 읽고 같은 일을 반복한다.
현재 위치는 모수 하나, 높이는 손실, 이동 배율은 학습률이다. 이 반복이 일변수 경사하강법이다. 인공지능이 자료로 ‘학습한다’는 말은 대부분 이 반복을 아주 많은 모수에 대해 하는 것이다. 여기서는 손실함수의 기울기에서 구한 미분계수로 추세선의 기울기 하나를 고친다.
일변수 경사하강법은 기울기에 학습률을 곱해 모수에서 뺀다
일변수 경사하강법은 현재 손실의 미분계수에 양의 학습률을 곱해 현재 모수에서 빼는 반복 방법이다. 미분계수가 양수이면 모수가 작아지고, 음수이면 커진다. 어느 경우든 작은 변화에서 손실이 줄어드는 쪽을 향한다.
| 기호 | 이름 | 원어 | 뜻 |
|---|---|---|---|
| 수정 횟수 | iteration | 0부터 세는 정수, 0은 수정 전 | |
| 현재 모수 | parameter | 번 수정한 추세선의 기울기, 은 초깃값 | |
| 현재 손실 | loss | 같은 고정 자료에 대한 오차 제곱의 평균 | |
| 손실의 기울기 | derivative | 현재 모수에서의 미분계수 | |
| 학습률 | learning rate | 기울기에 곱하는 양의 상수 |
교과서는 학습률을 로 쓰고, 식 (1)을 ‘경사하강법의 학습을 위한 식’이라 부른다. 처음에 임의로 정하는 은 초깃값이다. 학습률은 러닝레이트라고도 하며, 이 방법을 ‘일변수 경사 하강법’처럼 띄어 쓰기도 한다.
학습률은 이동 거리 자체가 아니다. 실제 변화량은 이므로, 같은 학습률이어도 현재 기울기에 따라 달라진다.
경사하강법에서 기울기가 음수인데 왜 모수가 커질까?
경사하강법은 기울기에 학습률을 곱한 값을 빼기 때문에, 기울기가 음수이면 모수가 커진다. 음수 기울기 −8에 학습률 0.1을 곱한 −0.8을 빼면 모수는 0.8 커진다. 기울기가 음수라는 것은 오른쪽으로 갈수록 손실이 낮아진다는 뜻이므로 방향이 맞다.
일변수 경사하강법을 다섯 번 반복하면 손실은 얼마나 줄까?
초깃값 0, 학습률 0.1로 다섯 번 수정하면 모수는 1.55가 되고 손실은 6.5에서 0.10625로 준다. 가상 자료 , 과 예측식 를 이어 쓰며, 일변수 제곱 손실과 그 기울기는 다음과 같다.
첫 기울기는 이다. 음수를 빼므로 모수는 오른쪽으로 움직인다.
새 위치에서 기울기를 다시 계산하면 다. 따라서 두 번째 수정은 다. 처음 구한 −8을 계속 쓰는 것이 아니다.

figures/descent_on_loss_curve.py그림 1에서 걸음은 0.8, 0.4, 0.2로 작아진다. 식 (2)의 기울기를 으로 쓰면 이유가 보인다. 기울기의 크기가 최적값 1.6까지 거리의 5배여서, 멀리 있을 때 크게, 가까이 있을 때 작게 움직인다.
| 수정 횟수 | 모수 | 손실 |
|---|---|---|
| 0 | 0 | 6.5 |
| 1 | 0.8 | 1.7 |
| 2 | 1.2 | 0.5 |
| 3 | 1.4 | 0.2 |
| 4 | 1.5 | 0.125 |
| 5 | 1.55 | 0.10625 |

figures/parameter_updates.py그림 2처럼 모수는 1.6에 가까워지지만 다섯 번 뒤에도 1.55다. 완전제곱으로 구한 최소 손실 0.1과도 아직 0.00625 차이가 난다. 다섯 번 계산한 결과와 ‘어떤 조건에서 계속 가까워지는가’라는 일반 질문은 아래 식 (4)로 따로 답한다.
학습률이 크면 왜 실패하고, 작으면 왜 느릴까?
학습률이 너무 크면 최소점을 지나 반대쪽의 더 높은 곳까지 가고, 너무 작으면 거의 움직이지 않는다. 같은 초깃값 0에서 학습률만 바꾸어 처음 세 번의 수정을 비교하자.
| 학습률 | 모수: 수정 전 → 1번 → 2번 → 3번 | 손실의 순서 |
|---|---|---|
| 0.02 | 0 → 0.16 → 0.304 → 0.4336 | 6.5 → 5.284 → 4.299 → 3.501 |
| 0.2 | 0 → 1.6 → 1.6 → 1.6 | 6.5 → 0.1 → 0.1 → 0.1 |
| 0.3 | 0 → 2.4 → 1.2 → 1.8 | 6.5 → 1.7 → 0.5 → 0.2 |
| 0.4 | 0 → 3.2 → 0 → 3.2 | 6.5 → 6.5 → 6.5 → 6.5 |
| 0.5 | 0 → 4 → −2 → 7 | 6.5 → 14.5 → 32.5 → 73 |
0.02 행의 손실 4.299와 3.501은 소수 넷째 자리에서 반올림했다. 0.02는 세 번 수정해도 0.43까지밖에 가지 못하고, 0.2는 한 번에 최적값에 도착한다. 0.3은 최소점 1.6을 지나 양쪽을 오가면서도 가까워진다.

figures/learning_rate_comparison.py그림 3에서 0.4는 0과 3.2를 되풀이하고 0.5는 갈수록 멀어진다. 학습률을 0으로 두면 모수가 0에 머물고, 음수로 두면 오르막으로 간다. 이면 이고 손실은 14.5로 커진다. 그래서 식 (1)은 을 조건으로 둔다.
이 경계값들은 이 손실함수에서 나온 값이다. 제곱오차의 평균 대신 합을 손실로 쓰면 기울기가 두 배인 이 되어, 같은 학습률 0.3이 멀어지는 쪽으로 바뀐다. 손실의 정의를 바꾸면 학습률도 다시 골라야 한다.
경사하강법이 최소점을 지나치면 실패한 걸까?
아니다. 경사하강법이 최소점을 지나쳐도 다시 계산한 기울기로 더 가까이 갈 수 있다. 학습률 0.3은 0에서 2.4로 최소점 1.6을 지나지만, 이후 1.2, 1.8로 오가며 1.6까지 거리가 0.8, 0.4, 0.2로 준다. 지나쳤는지보다 최적값까지의 거리가 줄고 있는지를 본다.
일변수 경사하강법은 왜 최적값에 가까워질까?
이 예에서 학습률이 0과 0.4 사이이면 최적값까지의 거리가 매번 같은 비율로 줄기 때문이다. 식 (1)과 식 (2)를 합치면 이고, 양변에서 최적값 1.6을 빼면 다음과 같다.
비율 의 절댓값이 1보다 작으면, 즉 이면 거리가 매번 배로 준다. 초깃값이 어디든 성립한다. 이면 라 거리가 절반씩 되고, 이면 라 부호는 뒤집히지만 크기는 역시 절반씩 된다.
손실도 같은 이유로 준다. 식 (2)는 이므로, 최소 손실 0.1과의 차이는 거리 제곱의 배다. 에서 그 차이는 6.4, 1.6, 0.4, 0.1, 0.025, 0.00625로 매번 배가 된다. 그래서 0.1과 0.3은 지나는 모수는 달라도 손실의 순서가 같다.

figures/ratio_by_learning_rate.py그림 4를 경우별로 정리하면 다음 표다. 최적값이 아닌 곳에서 출발한 경우이며, 정확한 최소점에서 출발하면 어느 학습률이든 기울기가 0이라 그 자리에 머문다.
| 학습률의 범위 | 비율 | 모수의 움직임 |
|---|---|---|
| 한쪽에서 다가간다 | ||
| 한 번에 1.6에 도착한다 | ||
| 1.6을 넘나들며 다가간다 | ||
| 같은 두 값을 오간다 | ||
| 넘나들며 멀어진다 |
이 계산은 다른 이차 손실에도 그대로 옮겨진다. 최솟값을 주는 모수를 , 최소 손실을 이라 하고 으로 쓰면 다. 식 (4)와 같은 방법으로 다음을 얻는다.
따라서 이면 가까워지고, 이면 한 번에 도착한다. 이 예는 , 이라 경계가 , 다.
일변수 경사하강법은 손실의 기울기에 양의 학습률을 곱해 모수에서 빼는 반복이며, 이차 손실 에서는 학습률이 0과 사이일 때 최적값에 가까워진다.
일변수 경사하강법은 언제 반복을 멈출까?
기울기의 크기가 미리 정한 작은 수 보다 작아지면 멈춘다. 최소점에서는 기울기가 0이므로, 가 0에 충분히 가까우면 최소점 근처라고 판단하는 것이다. 그림 5는 이 과정을 순서도로 나타낸 것이다.

figures/descent_flowchart.py로 정해 보자. 학습률 0.1에서는 , 라 8번 수정한 뒤 멈추고, 이때 다. 같은 기준에서 학습률 0.02는 49번이 걸린다. 0.4와 0.5는 식 (4)에 따라 기울기의 크기가 줄지 않으므로 멈추지 않는다. 그래서 실제로는 멈춤 기준과 함께 반복 횟수의 상한도 정해 둔다.
경사하강법은 항상 손실이 가장 작은 곳을 찾을까?
이차 손실에서는 학습률이 알맞으면 찾지만, 모든 손실에서 그렇지는 않다. 이 글의 손실처럼 아래로 볼록한 이차함수는 기울기 0인 점이 1.6 하나뿐이라, 학습률이 0과 0.4 사이면 어느 초깃값에서든 그곳으로 간다. 골짜기가 여러 개인 손실에서는 가장 낮지 않은 골짜기에서 멈출 수 있으며, 이는 경사하강법의 국소 최솟값 질문에서 다루는 확장 내용이다.
경사하강법의 학습률은 코드에서 무엇일까?
경사하강법의 학습률은 코드에서 갱신 한 줄에 곱하는 배율이다. 아래 코드랩의 eta = 0.1이 식 (1)의 이고, PyTorch의 torch.optim.SGD(params, lr=0.1)에서는 lr가 같은 역할을 한다. 좋은 값은 자료와 손실에 따라 다르므로, 인공지능 수학 탐구처럼 후보 몇 개를 검증 자료로 비교해 고른다.
일변수 경사하강법의 흔한 오해
- 학습률이 0.1이면 모수가 매번 0.1씩 바뀐다 — 표의 첫 변화는 0.8, 둘째 변화는 0.4다. 학습률은 매번 다른 기울기에 곱하는 배율이다.
- 반복 횟수만 늘리면 언제나 좋아진다 — 학습률 0.5에서는 첫 세 번 동안 손실이 14.5, 32.5, 73으로 커진다. 비율이 라 반복할수록 더 멀어진다.
- 학습률은 작을수록 안전하다 — 0.02는 멀어지지는 않지만 기준 에 닿기까지 49번이 걸려, 0.1의 8번보다 훨씬 느리다. 0이면 아예 움직이지 않는다.
코드로 직접 다섯 번 수정하기
아래 Python 코드는 기울기만 공식으로 계산하고, 손실은 두 예측 오차에서 매번 다시 구한다. range(6)은 수정 전을 포함한 여섯 상태를 출력하며 마지막 출력 뒤에는 더 수정하지 않는다. eta=0.1을 0.02나 0.5로 바꾸어 앞 표의 느린 감소·증가와 비교해 보자.
data = [(1, 2), (2, 3)]
eta = 0.1
a = 0.0
for t in range(6):
    loss = sum((a*x-y)**2 for x, y in data) / len(data)
    print(f"{t} {a:.6f} {loss:.6f}")
    if t < 5:
        slope = 5*a - 8
        a = a - eta*slope  # 식 (1)
$ python descent_lab.py
0 0.000000 6.500000
1 0.800000 1.700000
2 1.200000 0.500000
3 1.400000 0.200000
4 1.500000 0.125000
5 1.550000 0.106250출력의 끝은 5 1.550000 0.106250이다. 컴퓨터의 소수 연산은 반올림 오차를 가질 수 있으므로 보이는 자릿수와 수학적인 정확값을 구별한다. 유한 번의 실행 확인은 식 (4)의 일반 이유를 대신하지 않는다.
직접 해보기
1·2·5번은 새 손실 를 쓴다. 이 함수의 기울기는 이다. 3·4번의 기울기는 앞 글의 공식, 곧 의 미분계수 로 구한다.
- , 학습률 0.25로 한 번 수정한 모수와 그 손실을 구하라.
- 같은 초깃값에서 학습률 1로 두 번 수정해 보라. 최적값 3에 가까워지는지 판단하라.
- 손실 에서 초깃값 4, 학습률 0.1로 한 번 수정한 모수를 구하고, 손실이 얼마에서 얼마로 바뀌는지 구하라.
- 손실 에서 초깃값 를 한 번 수정했더니 이 되었다. 학습률은 얼마인가? 이 학습률로 한 번에 최소점에 도착한 이유를 식 (5)로 설명하라.
- 에서 최적점까지의 차이가 다음번에 배가 됨을 보이고, 차이의 크기가 줄어드는 양의 학습률 범위를 구하라. 초깃값이 3이면 어떻게 되는가?
답과 풀이
- 이므로 다. 으로 처음 보다 작다.
- 이다. 최적점 3까지 거리가 계속 2이므로 가까워지지 않고, 손실도 6에서 변하지 않는다.
- 이고 다. 이며, 손실은 에서 로 준다.
- 이고 이다. 에서 , 다. 의 최소점은 이고 이라 이므로, 식 (5)의 비율이 이 되어 한 번에 도착한다.
- 에서 3을 빼면 이다. 을 풀면 이다. 식 (5)에서 인 경우라 앞 손실의 경계 0.4와 다르다. 초깃값이 3이면 이라 어떤 학습률에서도 3에 머문다.
이 원리를 여러 모수로 넓히는 경사하강법은 선택 확장 읽기다. 현재 교과 계산에는 여러 변수의 미분을 요구하지 않는다.
더 읽기
- 교육부, 2022 개정 교육과정 고시 — 별책8 [12인수04-04]의 일변수 손실과 경사하강법 범위를 따른다.
- Google, Linear regression: Gradient descent — 손실 계산·기울기 계산·모수 수정의 반복 순서를 참고했다. 이 글의 학습률 경계는 자체 이차식에서 따로 도출했다.
- 씨마스, 인공지능 수학 167~168쪽 — 미분계수의 부호·절댓값과 갱신량의 관계, 학습률 를 쓴 ‘학습을 위한 식’(167쪽), 초깃값과 순서도(168쪽)를 실제 면에서 확인했다. ‘일변수 경사하강법은 언제 반복을 멈출까?’ §의 순서도는 168쪽의 단계를 기호로 옮긴 것이다.
영상 노트
- 00:00 높이가 아닌 비탈로 방향 고르기
- 00:50 식 (1) — 음수를 빼면 오른쪽, 교과서의 k와 초깃값
- 02:00 식 (3)과 그림 1·2 — 다섯 번 수정, 걸음이 절반씩
- 03:30 표와 그림 3 — 너무 작은·알맞은·너무 큰 학습률
- 05:00 식 (4)·(5)와 그림 4 — 비율 r과 경계 1/A
- 06:30 그림 5 — 멈춤 기준 ε = 0.05, 8번과 49번
- 07:30 코드에서 학습률 바꾸고 새 손실에 적용
지도에서의 위치
- 2026-11-16 · 에이전트 초안 — 조건·계산·가상 자료와 새 연습 작성
- 2026-11-17 · 전수 검수 반영 — 교과서 표기(학습률 k·초깃값) 연결, 기울기에 비례하는 걸음의 이유, 작은·음수·0 학습률, 일반 이차 손실의 수렴 조건과 경우표, 멈춤 기준과 순서도, 교과서형 연습 추가 (에이전트 수정, 그림 2→5)
- 2026-11-17 · 전수 검수(에이전트 편집·독립 검증) 통과 — 주인 요청으로 완성으로 올림