직관 — 격자 그림의 틀린 칸 찾기
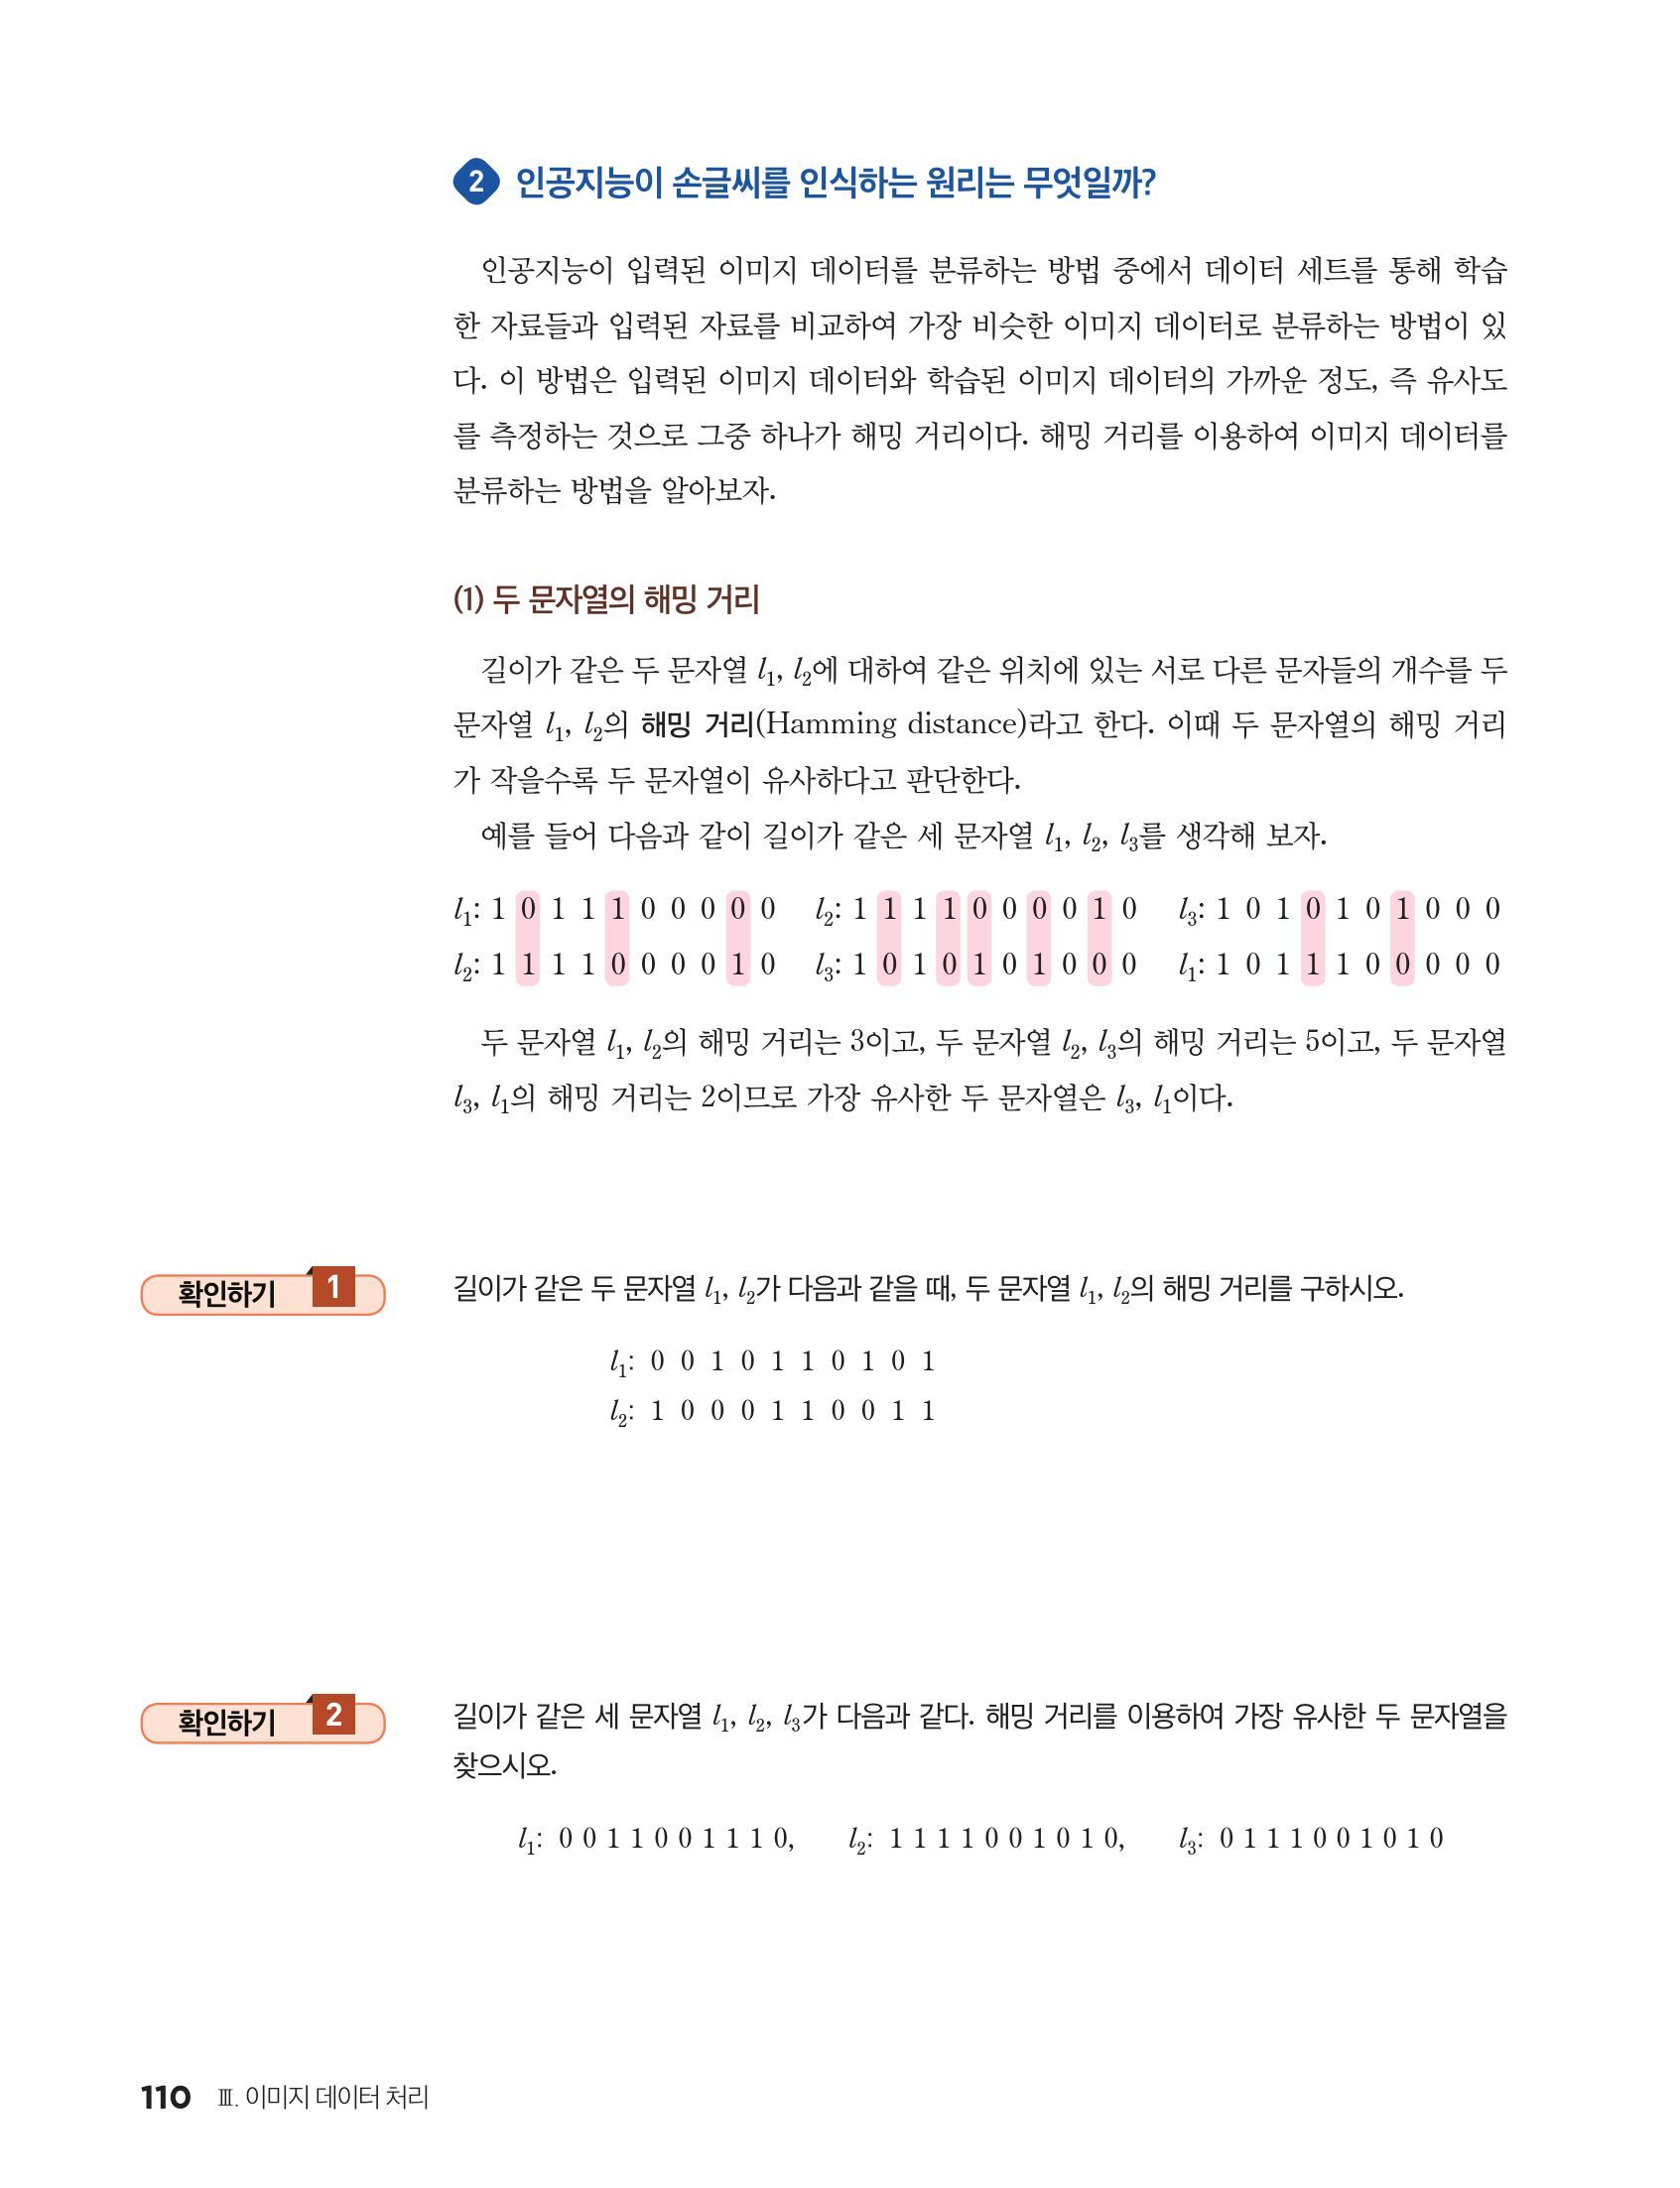
같은 크기의 격자에 그린 글자 두 장을 포개자. 칸마다 검정과 흰색이 일치하는지 확인하면 다른 칸을 셀 수 있다. 새 그림을 여러 기준 그림과 비교해 가장 적게 다른 쪽의 이름을 붙일 수 있다.
‘다른 칸의 개수’가 해밍 거리이고, 미리 이름을 붙여 둔 그림이 기준 이미지다. 새 그림에 가장 가까운 기준의 이름을 붙이는 것이 이 글의 분류 규칙이다. 인공지능이 학습한 이미지와 새 이미지를 비교해 가장 비슷한 쪽으로 판단하는 방법의 가장 단순한 꼴이며, 여기서는 작은 가상 글자 그림으로 원리를 드러낸다.
해밍 거리는 무엇을 세는가?
해밍 거리(Hamming distance)는 길이가 같은 두 문자열에서 같은 위치에 있는 서로 다른 문자의 개수다. 1011101과 1001001은 셋째와 다섯째 자리만 달라 해밍 거리가 2다. 길이가 다른 1011101과 101110은 자리끼리 짝이 맞지 않으므로 해밍 거리를 구하지 않는다. 거리가 작을수록 두 문자열이 비슷하다고 판단한다.
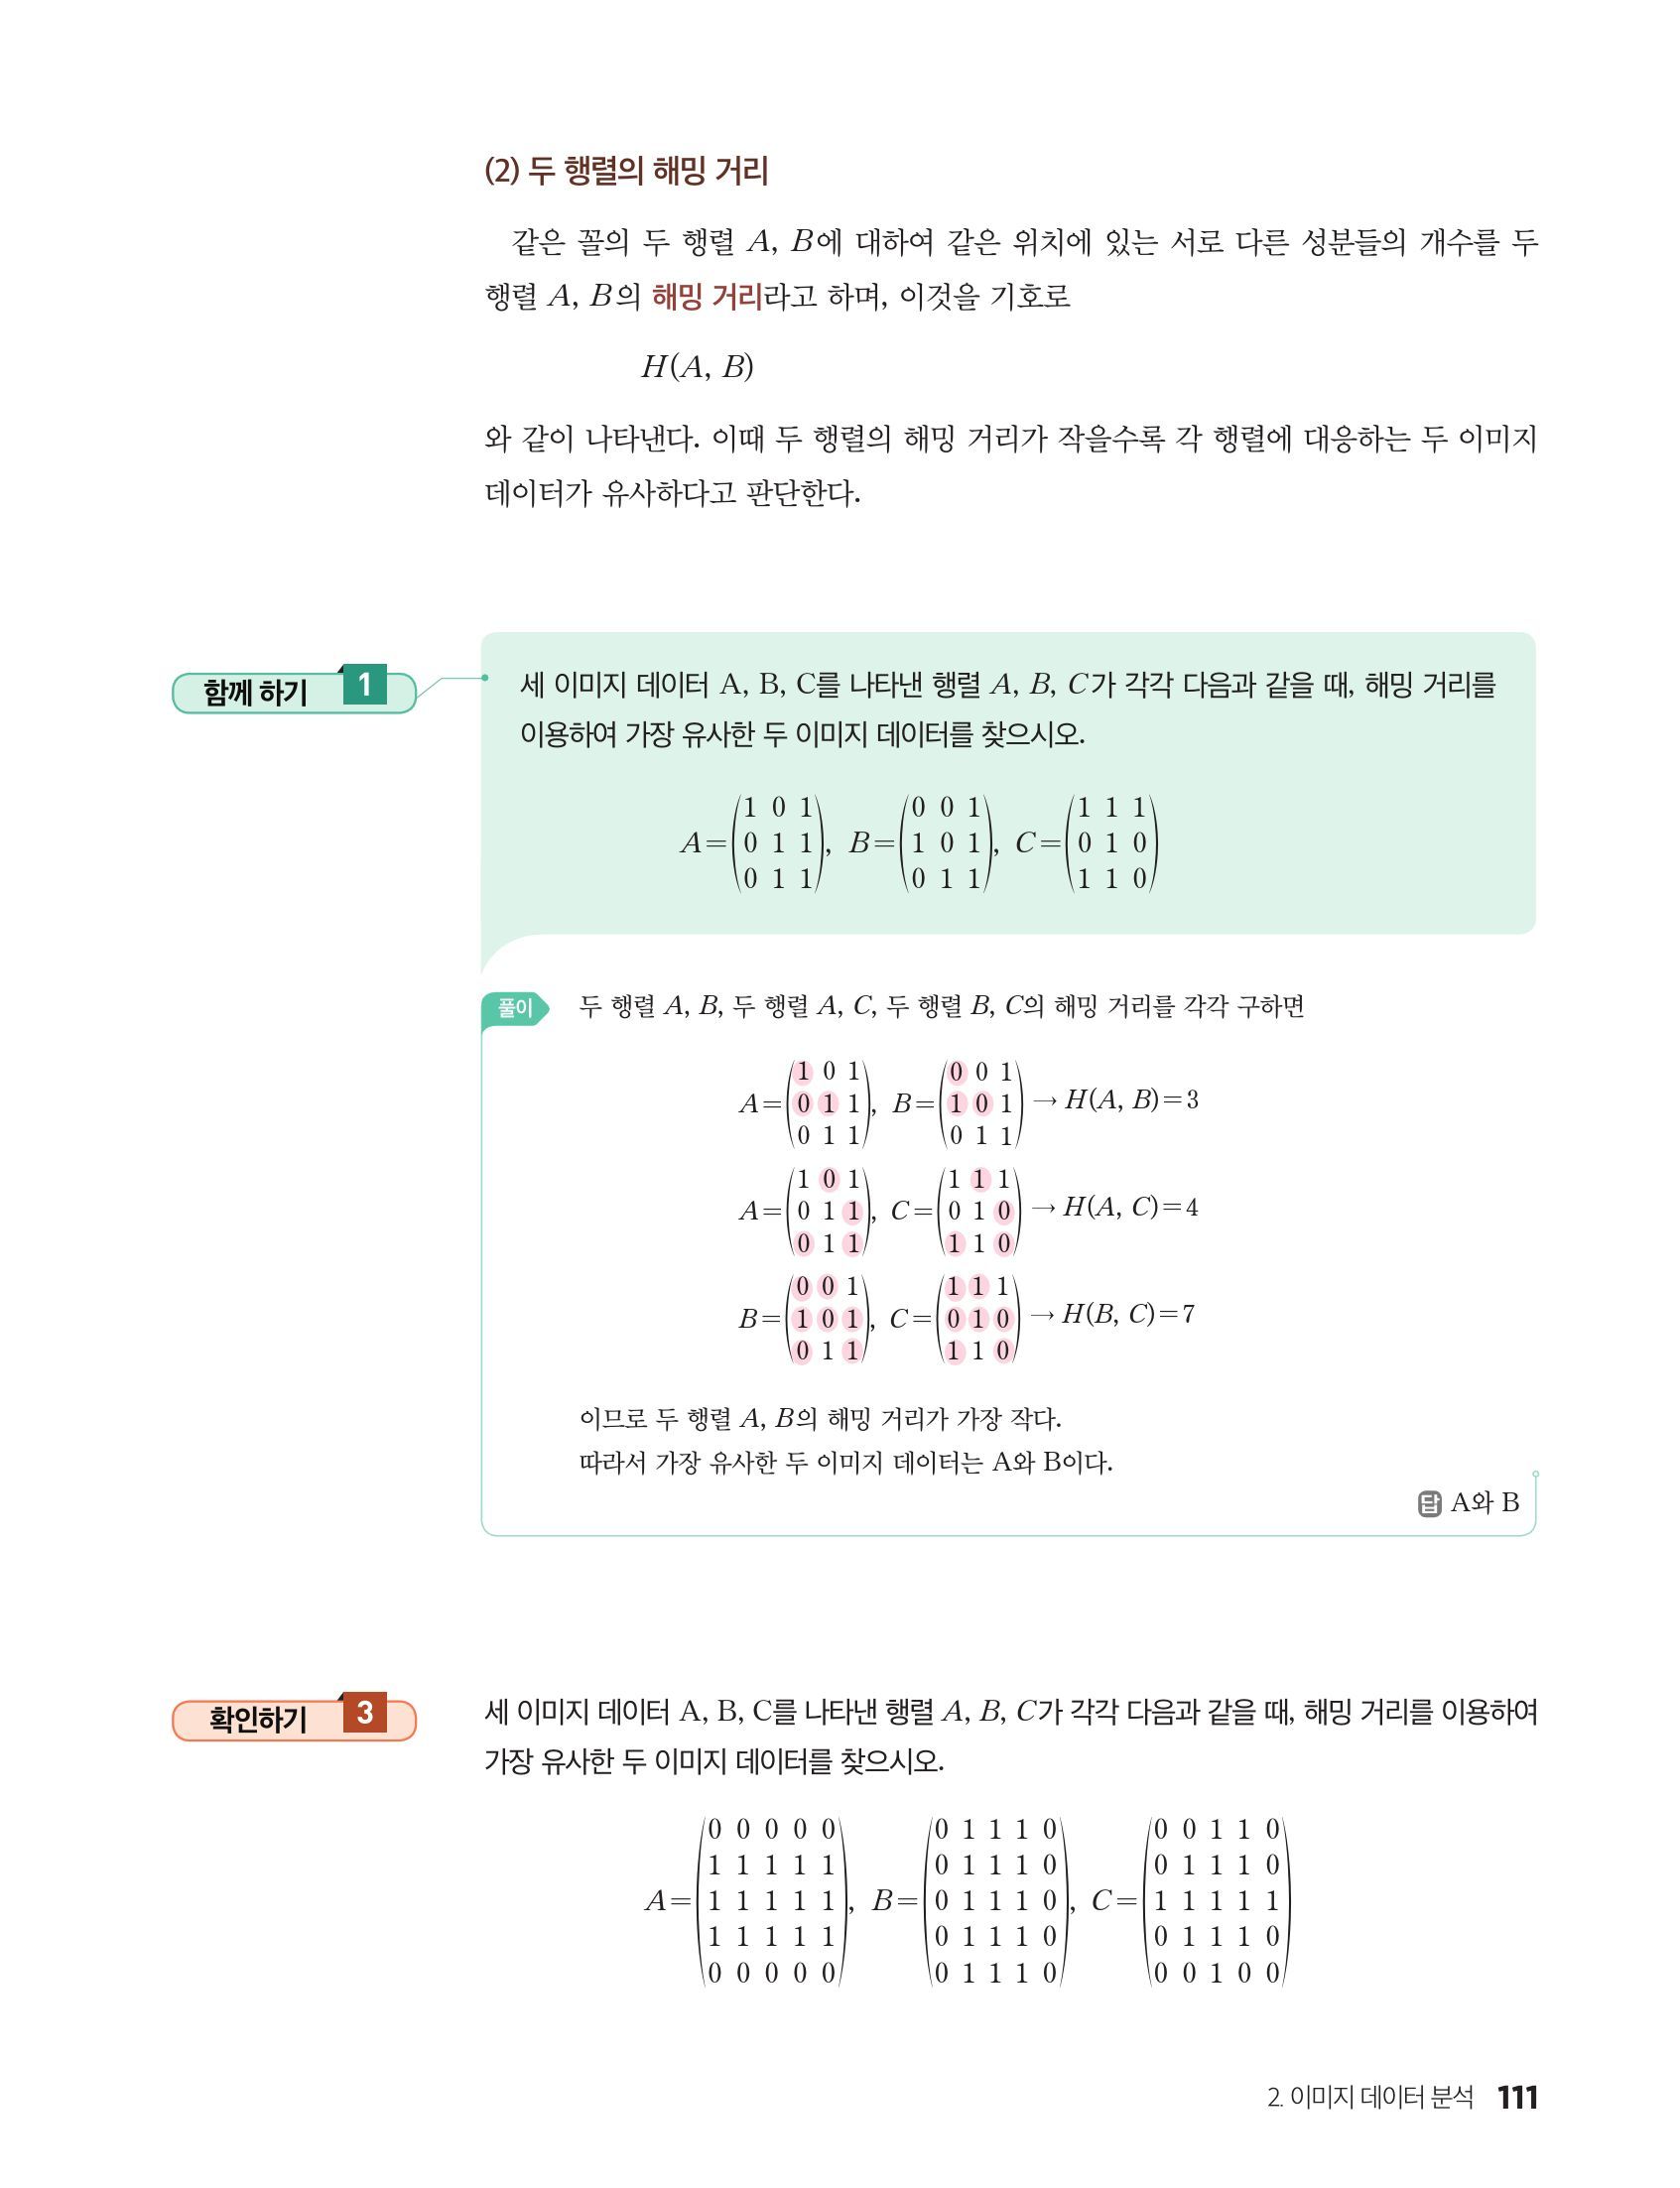
이미지도 같은 방법으로 비교한다. 이미지의 픽셀 행렬처럼 이미지를 행렬로 나타내면, 크기가 같은 두 행렬 에서 값이 다른 위치를 센다. 먼저 각 위치에서 두 값이 다르면 1, 같으면 0을 적은 차이 마스크를 만든다.
| 기호 | 이름 | 원어 | 뜻 |
|---|---|---|---|
| 비교 이미지 | images to compare | 행 수와 열 수가 같은 두 행렬 | |
| 성분 | entry | 같은 행 열 위치의 값 | |
| 행 수·열 수 | rows, columns | 두 이미지에 공통인 크기 | |
| 차이 마스크 | difference mask | 두 값이 다르면 1, 같으면 0 | |
| 해밍 거리 | Hamming distance | 값이 다른 위치의 개수 |
식 (2)의 합 기호는 행 를 1부터 까지, 열 를 1부터 까지 돌며 마스크 값을 더하라는 뜻이다. 교과서는 크기가 같은 행렬을 같은 꼴이라 하고, 해밍 거리를 로 쓴다. 이 페이지의 와 같다.
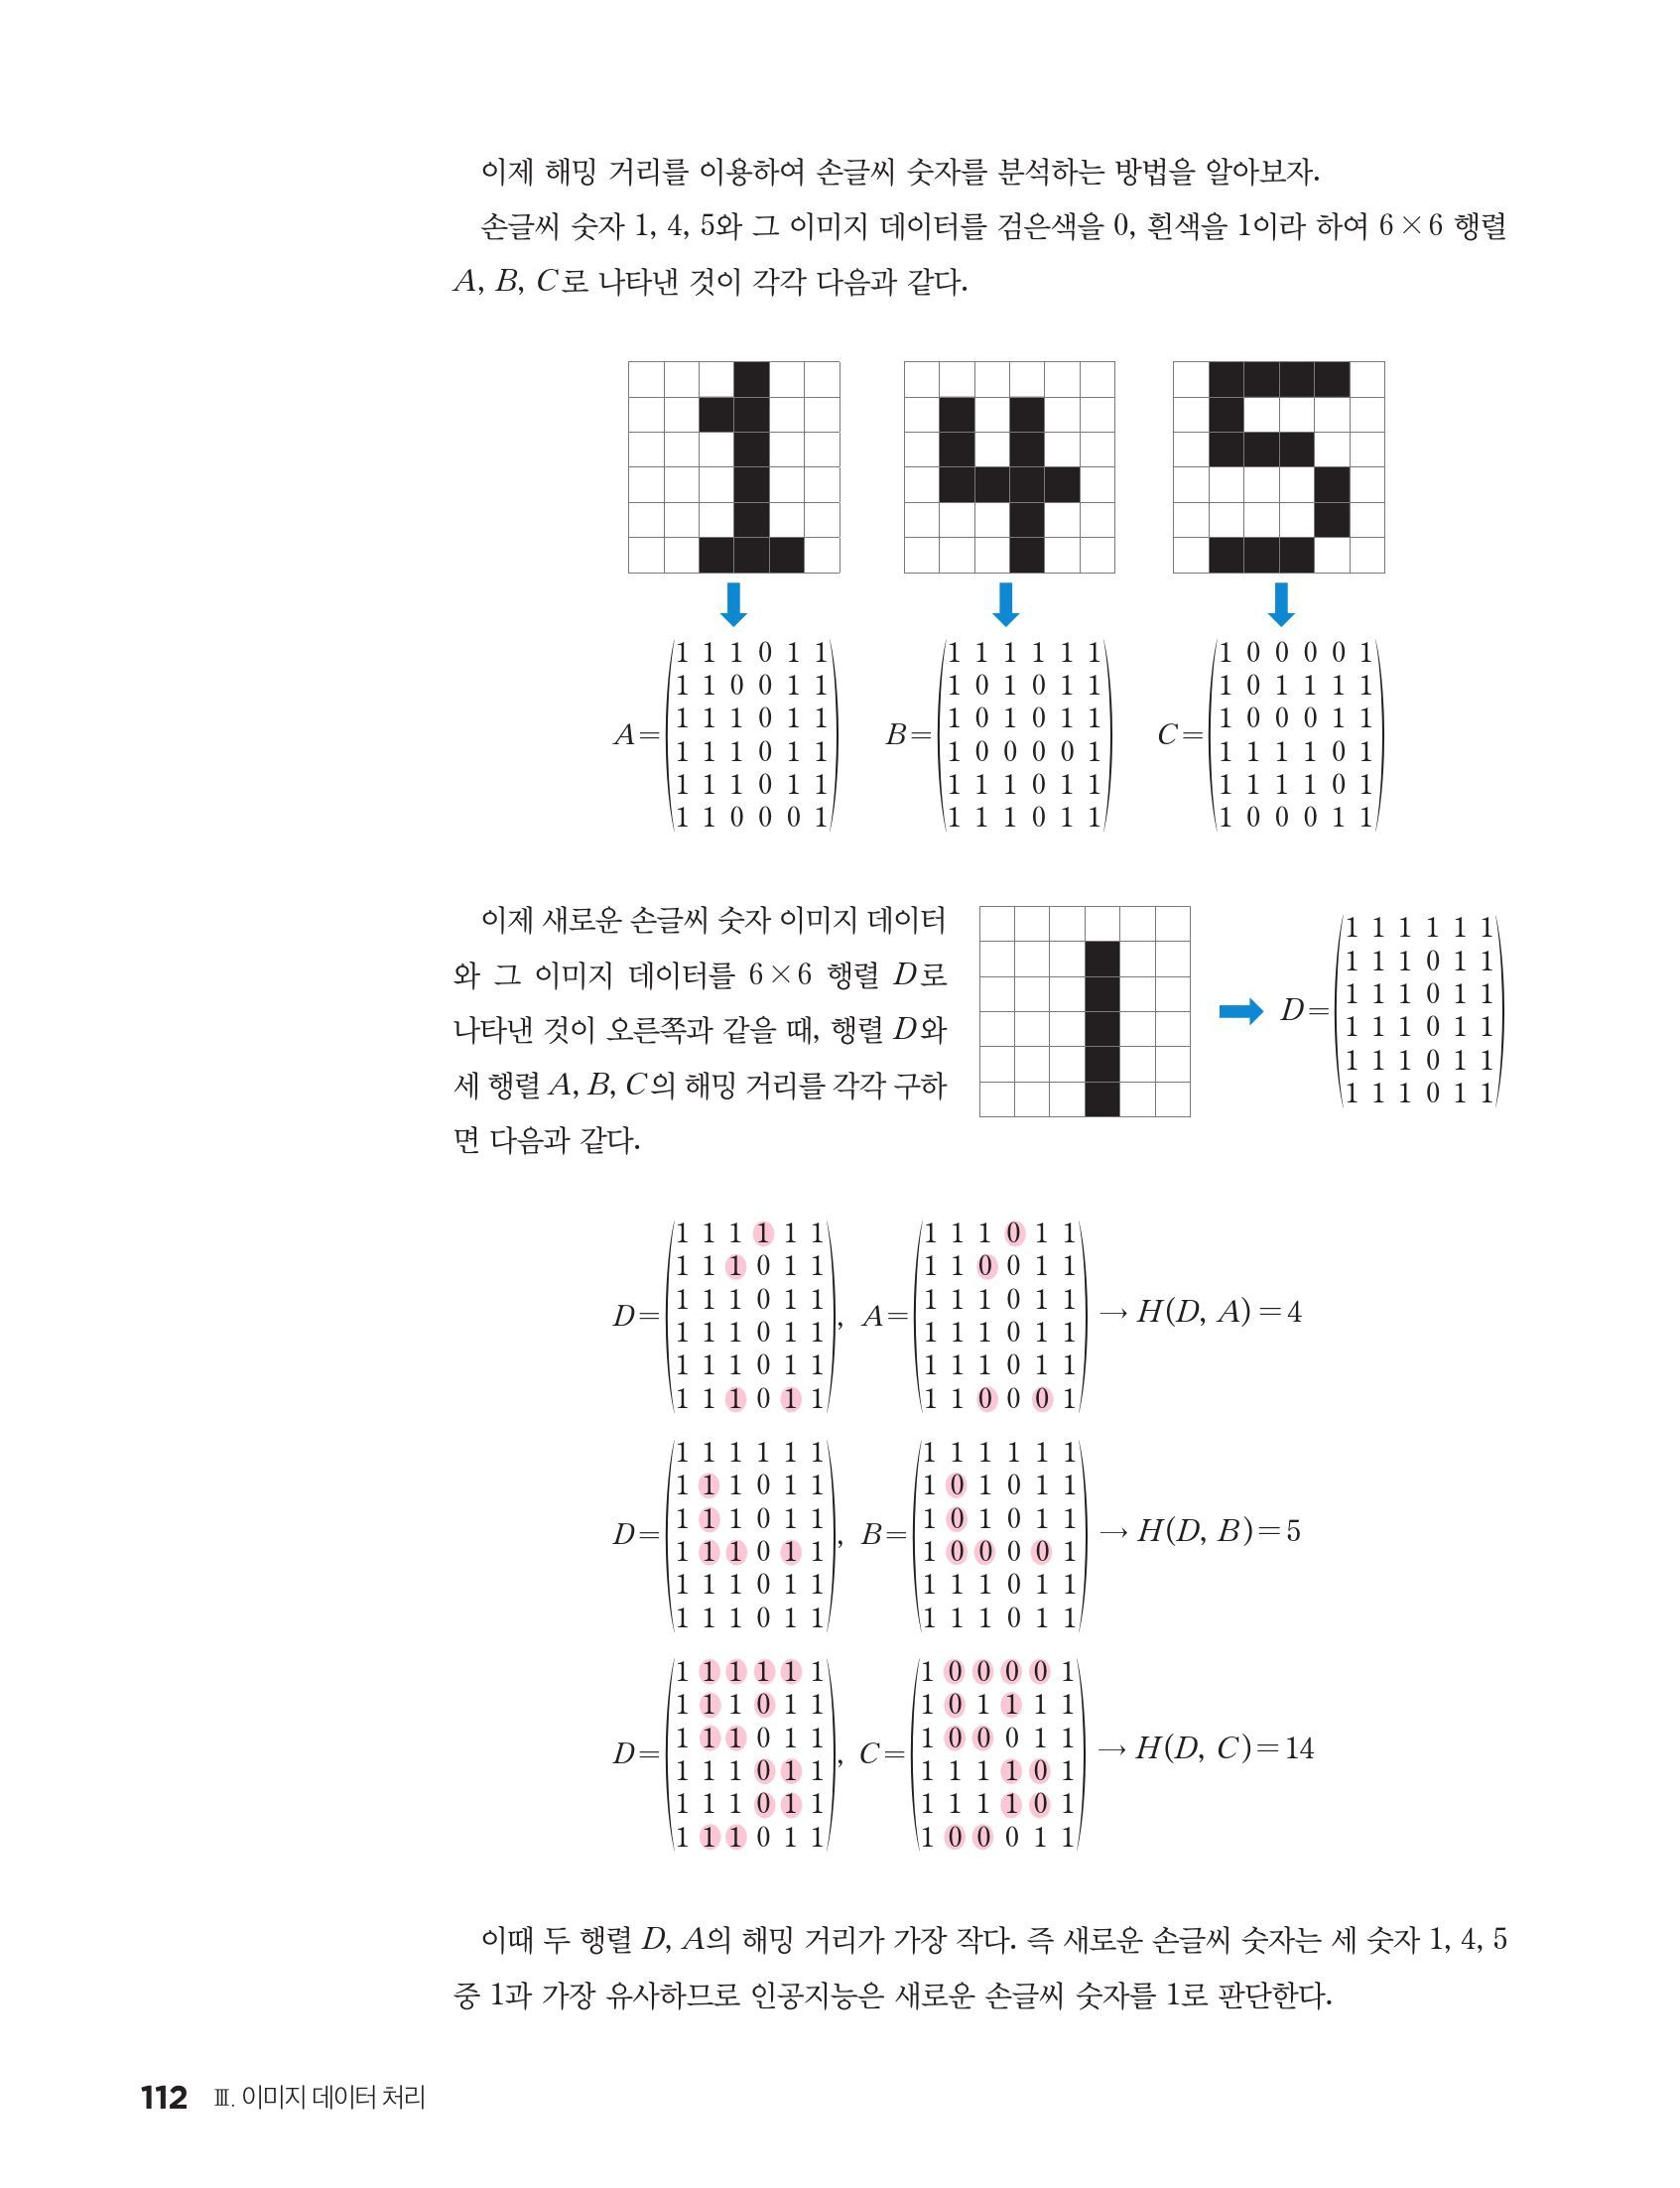
이 글의 이진 이미지는 1을 검정, 0을 흰색으로 정한다. 1은 ‘글자 선이 있는 칸’이라는 표시이며 명암 1을 뜻하지 않는다. 교과서의 손글씨 예는 반대로 검정을 0, 흰색을 1로 정한다. 두 이미지에 같은 약속을 쓰면 다른 칸의 위치가 그대로이므로 해밍 거리도 같다.
값이 0과 1뿐이면 같은 값의 차이는 0이고, 다른 값의 차이의 절댓값은 1이다. 그래서 식 (1)의 마스크는 차이의 절댓값과 같고, 0·1 이미지의 해밍 거리를 이렇게도 쓴다.
한 칸은 0 또는 1만 보태므로 해밍 거리는 0부터 까지의 정수다. 거리가 0이면 두 이미지가 같고, 비교 순서를 바꿔도 다. 가장 큰 값 은 검정과 흰색을 완전히 뒤집은 이미지와 비교할 때 나오며, 3×3에서는 9다.
두 기준 중 어느 쪽이 가까울까?
3행 3열의 기준 두 개를 정하고, 사람이 미리 이름 T와 L을 붙였다. 가장 가까운 기준의 이름을 출력한다는 규칙도 미리 정한다.
새 입력 는 다음과 같다.
식 (1)로 와 각 기준의 차이 마스크를 만든다. 왼쪽은 와, 오른쪽은 과 비교한 마스크다.
마스크의 1을 행별로 세어 더하면 식 (2)의 거리가 된다. 행별로 먼저 세면 놓친 칸을 찾기 쉽다.

figures/hamming_templates.py그림 1과 식 (7)에서 이므로 를 T로 분류한다. 결과는 ‘정해 둔 두 기준 중 T에 더 가깝다’는 뜻이며, 사람의 글자 판단과 늘 같지는 않다.
세 이미지 중 가장 비슷한 두 이미지를 고르는 문제도 같은 계산이다. 세 쌍의 거리를 모두 구해 가장 작은 쌍을 고른다. , , 이므로 가장 비슷한 쌍은 와 다.
회색조 이미지는 문턱값으로 0과 1로 바꾼다
0부터 255까지의 명암을 가진 회색조 이미지는 먼저 0과 1로 바꾸는데, 이를 이진화라 한다. 문턱값 를 정해 명암 가 보다 작은 어두운 칸을 1(검정 선), 나머지를 0으로 둔다. 이진화한 값을 라 하자.
다음 회색조 입력 를 두 문턱값으로 이진화해 보자. 8비트 명암이라 0이 검정, 255가 흰색이다.
이면 20, 30, 40, 60만 1이 되어 식 (5)의 를 얻는다. 이면 135, 140, 145, 150도 1이 되어 다음 가 된다.

figures/threshold_binarize.py그림 2처럼 같은 입력도 문턱값에 따라 다른 이진 이미지가 된다. 그림 3은 정수 를 0부터 256까지 바꾸며 두 거리를 그린 것이다. 가 31 이상 150 이하일 때만 T가 더 가깝고, 그보다 작거나 크면 두 거리가 같아 분류가 정해지지 않는다.

figures/threshold_distance_steps.py가 너무 작으면 검정 칸이 거의 없고, 너무 크면 거의 모든 칸이 검정이 되어 모양이 사라진다. 그래서 기준 이미지와 입력 이미지는 같은 문턱값으로 이진화하고, 그 값을 결과를 보기 전에 고정한다.
해밍 거리가 같으면 어떻게 분류할까?
최소 해밍 거리가 동점이면 거리만으로는 한 종류를 정할 수 없다. 식 (10)의 는 와 모두와 3칸이 달라 어느 쪽인지 말해 주지 않는다. 이때는 ‘보류’를 출력하거나 미리 정한 우선순위를 따르되, 그 규칙을 결과를 보기 전에 밝혀야 한다.
가장 가까운 기준이 있어도 너무 멀면 문제가 된다. ㅁ 모양 은 , 이라 L이 된다. 기준에 없는 모양도 두 이름 중 하나를 받는 것이다.
그래서 다음과 같은 보류 규칙을 미리 정할 수 있다. 최소 거리가 2 이하이고 그 거리를 갖는 기준이 하나일 때만 이름을 붙이고, 아니면 보류한다. 이 규칙으로 는 T, 와 는 보류가 된다.
규칙의 성능은 기준으로 쓰지 않은 새 그림으로 확인한다. 기준 와 을 입력으로 다시 넣으면 거리 0이라 2개 중 2개를 맞히지만, 이 결과는 처음 보는 그림을 잘 분류한다는 증거가 아니다. 기계학습의 방식에서 학습 자료와 평가 자료를 나누는 이유와 같다.
위치가 한 칸 어긋나면 해밍 거리는 얼마나 커질까?
해밍 거리는 같은 위치끼리만 비교하므로, 모양이 같아도 한 칸만 어긋나면 크게 늘어난다. 그림 4의 는 5×5 격자의 3열을 채운 세로 막대이고, 는 같은 막대를 한 칸 오른쪽으로 옮긴 것이다. 의 검정 5칸은 에서 흰색이고, 의 검정 5칸은 에서 흰색이라 이다.
아무것도 그리지 않은 는 의 검정 5칸만 달라 다. 같은 막대를 옮긴 그림이 빈 그림보다 두 배 멀다. 해밍 거리로 분류하기 전에 글자의 위치와 크기를 맞추는 전처리가 필요한 이유다.

figures/shift_sensitivity.py해밍 거리는 같은 크기와 위치 대응을 가진 두 이미지에서 값이 다른 칸의 개수다. 가장 가까운 기준 이미지로 분류할 수 있지만, 이진화 문턱값과 동점·보류 규칙은 미리 정하고 위치 어긋남은 따로 처리해야 한다.
회색조 값의 차이를 더해도 해밍 거리일까?
일반 회색조에서는 값의 차이 크기를 더한 것이 해밍 거리가 아니다. 두 칸이 과 이면 다른 위치는 1개지만 차이의 절댓값 합은 5다. 식 (3)의 절댓값 합이 개수와 같은 것은 값이 0과 1뿐일 때다. 10과 11처럼 거의 같은 명암도 다른 칸 1개로 세므로, 회색조는 식 (8)로 먼저 이진화한다.
크기가 다른 두 이미지의 해밍 거리는 구할 수 있을까?
해밍 거리는 같은 크기에서 위치끼리 짝을 지어 세므로, 크기가 다른 두 이미지는 공통 크기로 맞춘 뒤에야 구한다. 길이 7과 6인 문자열을 비교하지 않는 것과 같다. 테두리를 자르거나 빈칸을 채워 공통 크기로 만드는 규칙을 먼저 정해야 하며, 그 규칙에 따라 거리가 달라진다.
해밍 거리 분류에서 흔한 오해
- 검정 칸 수가 같으면 해밍 거리가 0이다 — 그림 4의 와 는 검정 칸이 5개씩 같지만 거리는 10이다. 해밍 거리는 검정 칸의 개수가 아니라 칸마다 값을 비교한다.
- 거리가 작으면 정답 확률을 계산한 것이다 — 거리 1과 5는 칸 수다. 이를 바로 1/6과 5/6 같은 확률로 해석할 근거는 없다. 실제 정답 비율은 별도 자료에서 상대도수로 예측하기처럼 확인한다.
코드로 해밍 거리 확인하기
NumPy에서 Q != ref는 각 위치에서 두 값이 다른지 비교한 결과이고, 이를 0·1로 바꾸면 식 (1)의 마스크가 된다. 마스크를 모두 더한 값이 식 (2)의 거리다. 출력의 둘째 수는 거리를 전체 칸 수 9로 나눈 불일치 비율이고, 마지막 세 줄은 과 비교한 마스크로 식 (6)의 오른쪽과 같다.
import numpy as np
T = np.array([[1, 1, 1], [0, 1, 0], [0, 1, 0]])
L = np.array([[1, 0, 0], [1, 0, 0], [1, 1, 1]])
Q = np.array([[1, 1, 1], [0, 0, 0], [0, 1, 0]])
for name, ref in [("T", T), ("L", L)]:
    mask = (Q != ref).astype(int)   # 식 (1) 차이 마스크
    dist = int(mask.sum())          # 식 (2) 해밍 거리
    print(name, dist, round(dist / mask.size, 3))
print(mask)
$ python hamming_lab.py
T 1 0.111
L 5 0.556
[[0 1 1]
[1 0 0]
[1 0 1]]SciPy의 해밍 거리는 왜 개수가 아니라 소수로 나올까?
SciPy의 distance.hamming은 다른 칸의 개수가 아니라 그 비율을 돌려준다. 이 글의 9칸을 같은 순서로 한 줄에 펼쳐 넣으면 와 는 개수 1 대신 이 나온다. 이름이 같아도 함수 문서의 단위를 확인한다.
직접 해보기
- , 의 해밍 거리를 구하라.
- 문자열 0110100과 1100110의 해밍 거리를 구하라. 0110100과 01101의 해밍 거리는 구할 수 있는가?
- 식 (4)의 에서 1행 3열만 1로 바꾼 새 입력 을 만들자. 중 어느 쪽으로 분류되는가?
- 식 (9)의 를 으로 이진화하자. 까지의 거리와 보류 규칙에 따른 결과를 구하라.
- , , 중 가장 비슷한 두 이미지를 찾아라.
답과 풀이
- 1행 1열과 2행 2열이 달라 다.
- 첫째·셋째·여섯째 자리가 달라 해밍 거리는 3이다. 0110100은 7자리, 01101은 5자리라 자리끼리 짝이 맞지 않으므로 구하지 않는다.
- 다. 과는 바꾼 1칸만 달라 거리 1이다. 와는 행별로 1칸, 2칸, 2칸이 달라 거리 5다. L로 분류한다.
- 아홉 값이 모두 230보다 작아 모든 칸이 1이다. 와 은 검정이 5칸씩이므로 흰 칸 4개가 달라 두 거리가 모두 4다. 동점이고 최소 거리도 2보다 크므로 보류한다.
- , , 이다. 가장 작은 1을 가진 과 이 가장 비슷하다.
더 읽기
- 교육부, 2022 개정 교육과정 고시 — 별책8 [12인수03-03]과 해밍 거리를 이용한 이미지 분류의 범위를 확인했다.
- 씨마스, 인공지능 수학 110쪽 — 윤상운 외, 2022 개정판. 길이가 같은 두 문자열의 해밍 거리와 가장 유사한 두 문자열 찾기를 실제 면으로 확인했다. ‘해밍 거리는 무엇을 세는가?’ §의 문자열 예가 기댄다.
- 씨마스, 인공지능 수학 111쪽 — 같은 모양의 두 행렬에서 다른 성분을 세는 정의를 실제 면으로 확인했다. 교과서의 를 이 글에서는 로 쓴다.
- 씨마스, 인공지능 수학 112쪽 — 6×6 손글씨 숫자를 검정 0·흰색 1로 나타내 가장 가까운 숫자로 판단하는 예를 확인했다. 이 글의 흑백 약속은 반대지만 해밍 거리는 같다.
- NIST, Hamming distance — 다른 비트 위치의 개수라는 정의를 읽었다. 그림과 분류용 수치는 이 글에서 만들었다.
- SciPy, distance.hamming — 라이브러리가 개수가 아닌 비율을 반환한다는 코드 해석의 근거다.
영상 노트
- 00:00 검정·흰색의 부호화 약속과 문자열의 해밍 거리
- 01:00 식 (1)·(2) — 차이 마스크를 만들고 더하기
- 02:10 식 (6)·(7)과 그림 1 — 1칸과 5칸 세기, 가장 비슷한 쌍
- 03:40 식 (8)~(10)과 그림 2 — 문턱값 128과 160으로 이진화
- 05:00 그림 3 — 문턱값에 따라 바뀌는 거리와 동점 구간
- 06:10 동점·보류 규칙과 기준 자료로 평가하면 안 되는 이유
- 07:20 그림 4 — 한 칸 옮긴 막대 S가 빈 그림 Z보다 먼 이유
- 08:30 코드랩 출력과 SciPy의 비율
지도에서의 위치
- 2026-11-16 · 독립 검수 — 표현 방법의 연결과 제목의 동의어 범위 정리
- 2026-11-16 · 에이전트 초안 — 정의·성립 이유·가상 자료와 새 연습 작성
- 2026-11-17 · 전수 검수 반영 — 문자열의 해밍 거리, 차이 마스크, 교과서 표기와 흑백 약속 다리, 거리의 범위와 성질, 가장 비슷한 쌍 찾기, 회색조 이진화 문턱값, 동점·보류 규칙과 평가 분리, 한 칸 이동 반례, 코드랩, 해보기 5문항 (에이전트 수정, 그림 1→4)
- 2026-11-17 · 전수 검수(에이전트 편집·독립 검증) 통과 — 주인 요청으로 완성으로 올림