직관 — 지난 기록에서 다음을 가늠하기
가상 분류기가 물건의 이름을 맞혔는지 스무 번 기록했다. 맞힌 칸이 열네 개라면 기록의 열 중 일곱 정도가 정답이다. 이 비율은 비슷한 상황의 다음 결과를 가늠하는 출발점이 된다.
여기서 세는 사건은 ‘정답을 맞힌다’다. 정답 판정 기준을 먼저 고정하고, 같은 물건의 중복 기록을 여러 독립적인 성능 증거처럼 세지 않는다. 해밍 분류 같은 규칙을 만들었어도, 실제로 얼마나 맞히는지는 자료로 확인해야 한다. AI 분류기의 정확도와 다음 낱말을 횟수로 고르는 단순한 언어 모델도 이렇게 센 비율에서 출발한다.
상대도수로 구한 확률은 사건 횟수를 전체 관측 횟수로 나눈 값이다
상대도수는 관측한 사건 횟수를 전체 관측 횟수로 나눈 비율이다. 전체 횟수는 0보다 커야 한다. 이 비율을 비슷한 조건에서 사건이 일어날 확률의 추정값, 즉 자료로 가늠한 값으로 쓸 수 있다.
| 기호 | 이름 | 원어 | 뜻 |
|---|---|---|---|
| 전체 관측 횟수 | number of observations | 사건 여부를 확인한 횟수, 양의 정수 | |
| 사건 횟수 | event count | 그중 사건이 일어난 횟수, 0 이상 이하인 정수 | |
| 확률의 추정값 | estimated probability | 이 글에서 상대도수 로 정한 예측의 근거 |
교과서는 자료의 표에서 구한 이 비율을 그대로 ‘…일 확률’이라고 쓴다. 이 글의 와 같은 값이다. 의 모자 모양은 자료로 구한 값이라는 뜻이며, 참된 확률을 정확히 알아냈다는 뜻은 아니다.
상대도수에서 배운 표의 비율에 ‘다음에도 비슷할까’라는 예측 질문을 덧붙인 것이다. 같은 조건의 반복 기록으로 확률을 어림하는 생각은 확률의 시작에서 다뤘다. 같은 수가 자료 요약값으로도, 예측에 사용하는 추정값으로도 쓰인다.
실제 관측에 바탕을 두어 예측하려면 자료 수집 조건이 중요하다. 밝은 곳의 선명한 사진만 골라 얻은 정답 비율을 어두운 사진에도 그대로 적용하기는 어렵다. 자료가 많아도 한 종류만 반복했다면 필요한 다른 종류의 성능을 보여 주지 않는다.
상대도수와 확률은 같은 말일까?
상대도수와 확률은 같은 말이 아니다. 상대도수는 실제 기록에서 센 비율이고, 확률은 사건이 일어날 가능성을 0 이상 1 이하의 수로 나타낸 값이다. 같은 조건의 기록에서 구한 상대도수를 확률의 어림값으로 쓰지만, 아래 표의 네 묶음처럼 5개씩 나눈 기록마다 0.6이나 0.8로 달라질 수 있다.
네 묶음의 가상 기록에서 상대도수 구하기
아래는 계산을 배우려고 구성한 가상 기록이다. 네 묶음 모두 새 사진 5개씩 판정했고, 이 예에서는 수집 조건과 정답 기준을 같게 두었다. 이미 이름을 확인한 예시를 모델에 외우게 한 뒤 다시 시험한 결과는 아니다.
| 묶음 | 전체 개수 | 맞힌 개수 | 틀린 개수 |
|---|---|---|---|
| 1 | 5 | 4 | 1 |
| 2 | 5 | 3 | 2 |
| 3 | 5 | 4 | 1 |
| 4 | 5 | 3 | 2 |
| 합계 | 20 | 14 | 6 |
전체 개수와 맞힌 개수를 각각 더한 뒤 식 (1)에 넣는다.
그림 1은 20개 기록을 칸으로 늘어놓은 것이다. 분모는 칸 전체 20개이고, 분자는 색칠한 칸 14개다. 묶음별로 나누어 세어도 전체를 한꺼번에 세어도 같은 칸을 세므로 결과가 같다.

figures/outcome_grid.py맞힌 기록의 비율은 70%다. 틀린 비율은 이며, 정답·오답이 모든 기록을 겹치지 않고 나누므로 두 비율의 합은 1이다. 결과가 둘 중 하나가 되도록 판정 기준을 정했기 때문에 가능한 확인이다.
그림 2는 기록을 하나씩 더할 때마다 다시 계산한 상대도수다. 5개에서 4/5, 10개에서 7/10, 15개에서 11/15로 오르내린 뒤 20개에서 14/20이 된다. 묶음 하나만 보고 예측했다면 묶음에 따라 0.6이나 0.8을 얻었을 것이다.

figures/accumulating_frequency.py관측을 늘리면 상대도수가 반드시 한 방향으로 움직일까?
아니다. 관측을 하나 추가할 때 상대도수는 커질 수도 작아질 수도 있다. 그림 2에서도 10개째의 7/10이 15개째 11/15로 올랐다가 20개째 14/20으로 내려왔다. 같은 조건의 반복에서 장기적인 비율을 살필 수는 있지만, 유한한 기록이 특정 참확률이나 일반적인 수렴을 증명하지는 않는다.
상대도수로 다음 결과를 어떻게 예측할까?
상대도수로 예측하는 방법은 두 가지다. 같은 조건에서 앞으로 번 관측할 때 사건이 일어날 횟수를 로 어림하거나, 여러 결과 가운데 상대도수가 가장 큰 결과를 고른다. 앞의 분류기로 같은 조건의 사진 장을 판정한다면 맞힐 장수는 다음과 같이 어림한다.
35장은 어림값이다. 실제로 맞힌 장수는 35에서 벗어날 수 있으며, 얼마나 벗어나는지는 다음 기록으로 확인한다.
여러 결과 중 하나를 고르는 예측도 같은 계산에서 시작한다. 가상의 글 모음에서 ‘오늘’ 바로 뒤에 온 낱말만 골라 20번을 세었다.
| ‘오늘’ 다음 낱말 | 날씨 | 점심 | 수업 | 합계 |
|---|---|---|---|---|
| 횟수 | 9 | 7 | 4 | 20 |
| 상대도수 | 0.45 | 0.35 | 0.2 | 1 |
상대도수가 가장 큰 결과는 0.45인 ‘날씨’이므로, 이 기록만으로는 ‘오늘’ 다음에 ‘날씨’를 예측한다. 다음 낱말을 횟수로 고르는 가장 단순한 언어 모델이 이 방식이다. 이 기록 20번에 이 예측을 쓰면 9번 맞고 11번 틀려, 틀리는 비율이 로 절반을 넘는다. 가장 흔한 결과라도 일어날 가능성이 절반을 넘는다는 보장은 없다.
‘오늘’ 다음만 골라 센 것은 예측할 상황과 같은 상황의 기록만 모은 것이다. 글 전체에서 낱말의 비율을 세면 ‘오늘 다음에 무엇이 올까’가 아니라 다른 질문에 답하게 된다.
상대도수는 계산이고, 그 값으로 무엇을 할지는 따로 정하는 결정이다. 정답률 0.7인 분류기를 실제 업무에 쓸지는 틀렸을 때 생기는 손해와 다른 방법의 비용까지 따져서 정한다.
크기가 다른 자료는 개수가 아니라 상대도수로 비교한다
전체 관측 횟수가 다른 자료를 비교할 때는 사건 횟수가 아니라 상대도수를 비교한다. 세 가상 분류기 A, B, C를 같은 종류의 사진으로 각각 40장, 50장, 80장 시험했더니 맞힌 장수가 26장, 40장, 56장이었다.
그림 3의 위쪽은 맞힌 개수, 아래쪽은 상대도수다. 개수로는 C가, 상대도수로는 B가 가장 크다. C는 시험한 사진이 많아서 맞힌 개수도 많을 뿐이다. 같은 조건의 새 사진을 판정할 분류기를 고른다면 상대도수가 가장 큰 B가 근거가 된다.

figures/group_ratio_comparison.py이 비교는 사진의 종류와 정답 기준이 같을 때 공정하다. B만 쉬운 사진으로 시험했다면 0.8과 0.7의 차이는 분류기의 차이가 아니라 사진의 차이일 수 있다. 상대도수의 차이가 작으면 다른 사진으로 다시 시험했을 때 순서가 바뀔 수도 있다.
새 기록이 들어오면 예측도 바뀔까?
예측은 시간 순서대로 확인한다. 앞의 20개 기록으로 구한 0.7을 쓰면, 같은 수집 조건으로 새로 판정할 10개 중 개를 맞힐 것으로 어림한다. 실제로는 6개를 맞혀 새 묶음의 상대도수는 이었다. 앞의 0.7이 틀린 계산이었던 것이 아니라, 유한한 기록마다 비율이 달라질 수 있기 때문이다.
두 묶음을 합쳐 다음 예측의 근거로 삼으려면 맞힌 개수끼리, 전체 개수끼리 더한다. 두 비율을 무조건 똑같은 비중으로 평균 내지 않는다.
그림 4는 식 (6)을 넓이로 보인다. 폭이 기록 수, 높이가 상대도수인 직사각형의 넓이가 맞힌 개수 14와 6이다. 합친 상대도수는 넓이의 합 20을 폭의 합 30으로 나눈 높이다. 과 의 단순 평균 는 폭 20과 10을 같은 크기로 취급한 값이다.

figures/merged_ratio_area.py새 자료의 환경이 달라졌다면 합계만 보여 주기보다 이전·새 환경의 결과를 나누어 보고 차이를 살펴야 한다. 어두운 사진이 새로 섞였다면 합친 2/3보다 환경별 비율이 더 쓸모 있는 정보다.
상대도수로 예측하기는 전체 관측이 0보다 많을 때 사건 횟수를 전체 횟수로 나눈 비율로 다음 결과의 가능성을 가늠한다. 관측 조건과 예측 대상을 맞춰야 하며, 그 비율이 다음 결과를 보장하지는 않는다.
상대도수 0.7이면 다음 열 번 중 정확히 일곱 번일까?
아니다. 관측 상대도수 0.7로 어림한 일곱 번은 다음 열 번의 결과를 보장하지 않는다. 이 글의 새 묶음은 열 번 중 여섯 번이었다. 한 번의 다음 결과는 정답 또는 오답이며, 비율은 여러 기록을 모아 판단하는 근거다.
한 번도 관측하지 못한 사건은 불가능할까?
아니다. 유한한 자료에서 사건 횟수가 0이면 그 자료에서 관측하지 못했다는 뜻이다. 예를 들어 새 기계의 시험 8번에서 고장이 없으면 관측 상대도수는 이다. 아직 시험하지 않은 환경이나 이후 시험에서 고장이 날 가능성까지 배제하지 않는다.
상대도수 예측에서 흔한 오해
- 자료 100개에서 90개를 맞히면 모든 종류를 잘 맞힌다 — 100개가 모두 같은 글자이면 다른 글자에 대한 정답 기록이 없다. 전체 비율 0.9만으로 종류별 성능을 대신할 수 없다.
- 확률의 분모는 맞힌 개수다 — 정답 확률을 추정할 때 분모는 전체 20개다. 로 계산하면 틀린 6개를 버린다.
- 앞에서 덜 맞혔으니 다음에는 더 맞혀 비율을 채운다 — 새 묶음이 0.6이었다고 다음 10개에서 8개를 맞혀 0.7로 돌아가게 되는 것은 아니다. 지난 기록의 비율은 다음 결과를 끌어당기지 않는다.
직접 해보기
- 가상 시험 25개에서 18개를 맞혔다. 정답과 오답의 상대도수를 구하라.
- 같은 조건의 첫 묶음 10개에서 8개, 다음 묶음 30개에서 15개를 맞혔다. 합친 상대도수를 구하고 단순 평균과 비교하라.
- 가상의 글 모음에서 ‘안녕’ 바로 뒤에 온 낱말을 25번 세었더니 ‘하세요’ 15번, ‘히’ 6번, ‘하십니까’ 4번이었다. 각 상대도수를 구하고 무엇을 예측할지 정하라. 같은 조건에서 ‘안녕’이 40번 더 나오면 ‘하세요’는 몇 번쯤으로 어림하는가?
- 같은 종류의 사진으로 분류기 X는 60장 중 45장, Y는 90장 중 63장을 맞혔다. 어느 분류기의 상대도수가 더 큰가?
- 실제로 확인한 15개에서는 결함이 하나도 없었다. 이 자료로 말할 수 있는 것과 말할 수 없는 것을 구별하라. 한 번도 시험하지 않은 분류기에 , 을 넣어 정답 비율 0이라 해도 될까?
답과 풀이
- 정답은 , 오답은 이다. 합은 1이다.
- 다. 개별 비율 0.8과 0.5의 단순 평균은 0.65로 다르다. 관측 수가 다른 두 묶음은 횟수를 먼저 합쳐야 한다.
- 상대도수는 , , 이고 합은 1이다. 가장 큰 ‘하세요’를 예측한다. 다음 40번에서는 번쯤으로 어림하며, 정확히 24번이라는 보장은 아니다.
- X는 , Y는 이다. 맞힌 장수는 Y가 63장으로 더 많지만 상대도수는 X가 더 크다.
- 확인한 15개에서 결함의 상대도수는 이라고 말할 수 있다. 모든 제품에 결함이 없거나 앞으로도 없다는 결론은 얻지 못한다. 시험하지 않은 분류기는 분모가 0이라 나눗셈이 정의되지 않으므로 ‘자료 없음’이지 ‘관측 비율 0’이 아니다.
다음 추세선으로 예측하기는 사건의 비율 대신 입력값에 대응하는 수치 자체를 예측한다.
더 읽기
- 교육부, 2022 개정 교육과정 고시 — 별책8 [12인수04-01]과 상대도수 중심의 예측 범위를 따른다.
- OpenStax, Introductory Statistics 2e 3.1절 — 사건의 관측 비율과 확률을 연결하는 초반 설명을 읽었다. 이 글의 가상 자료는 직접 만들었다.
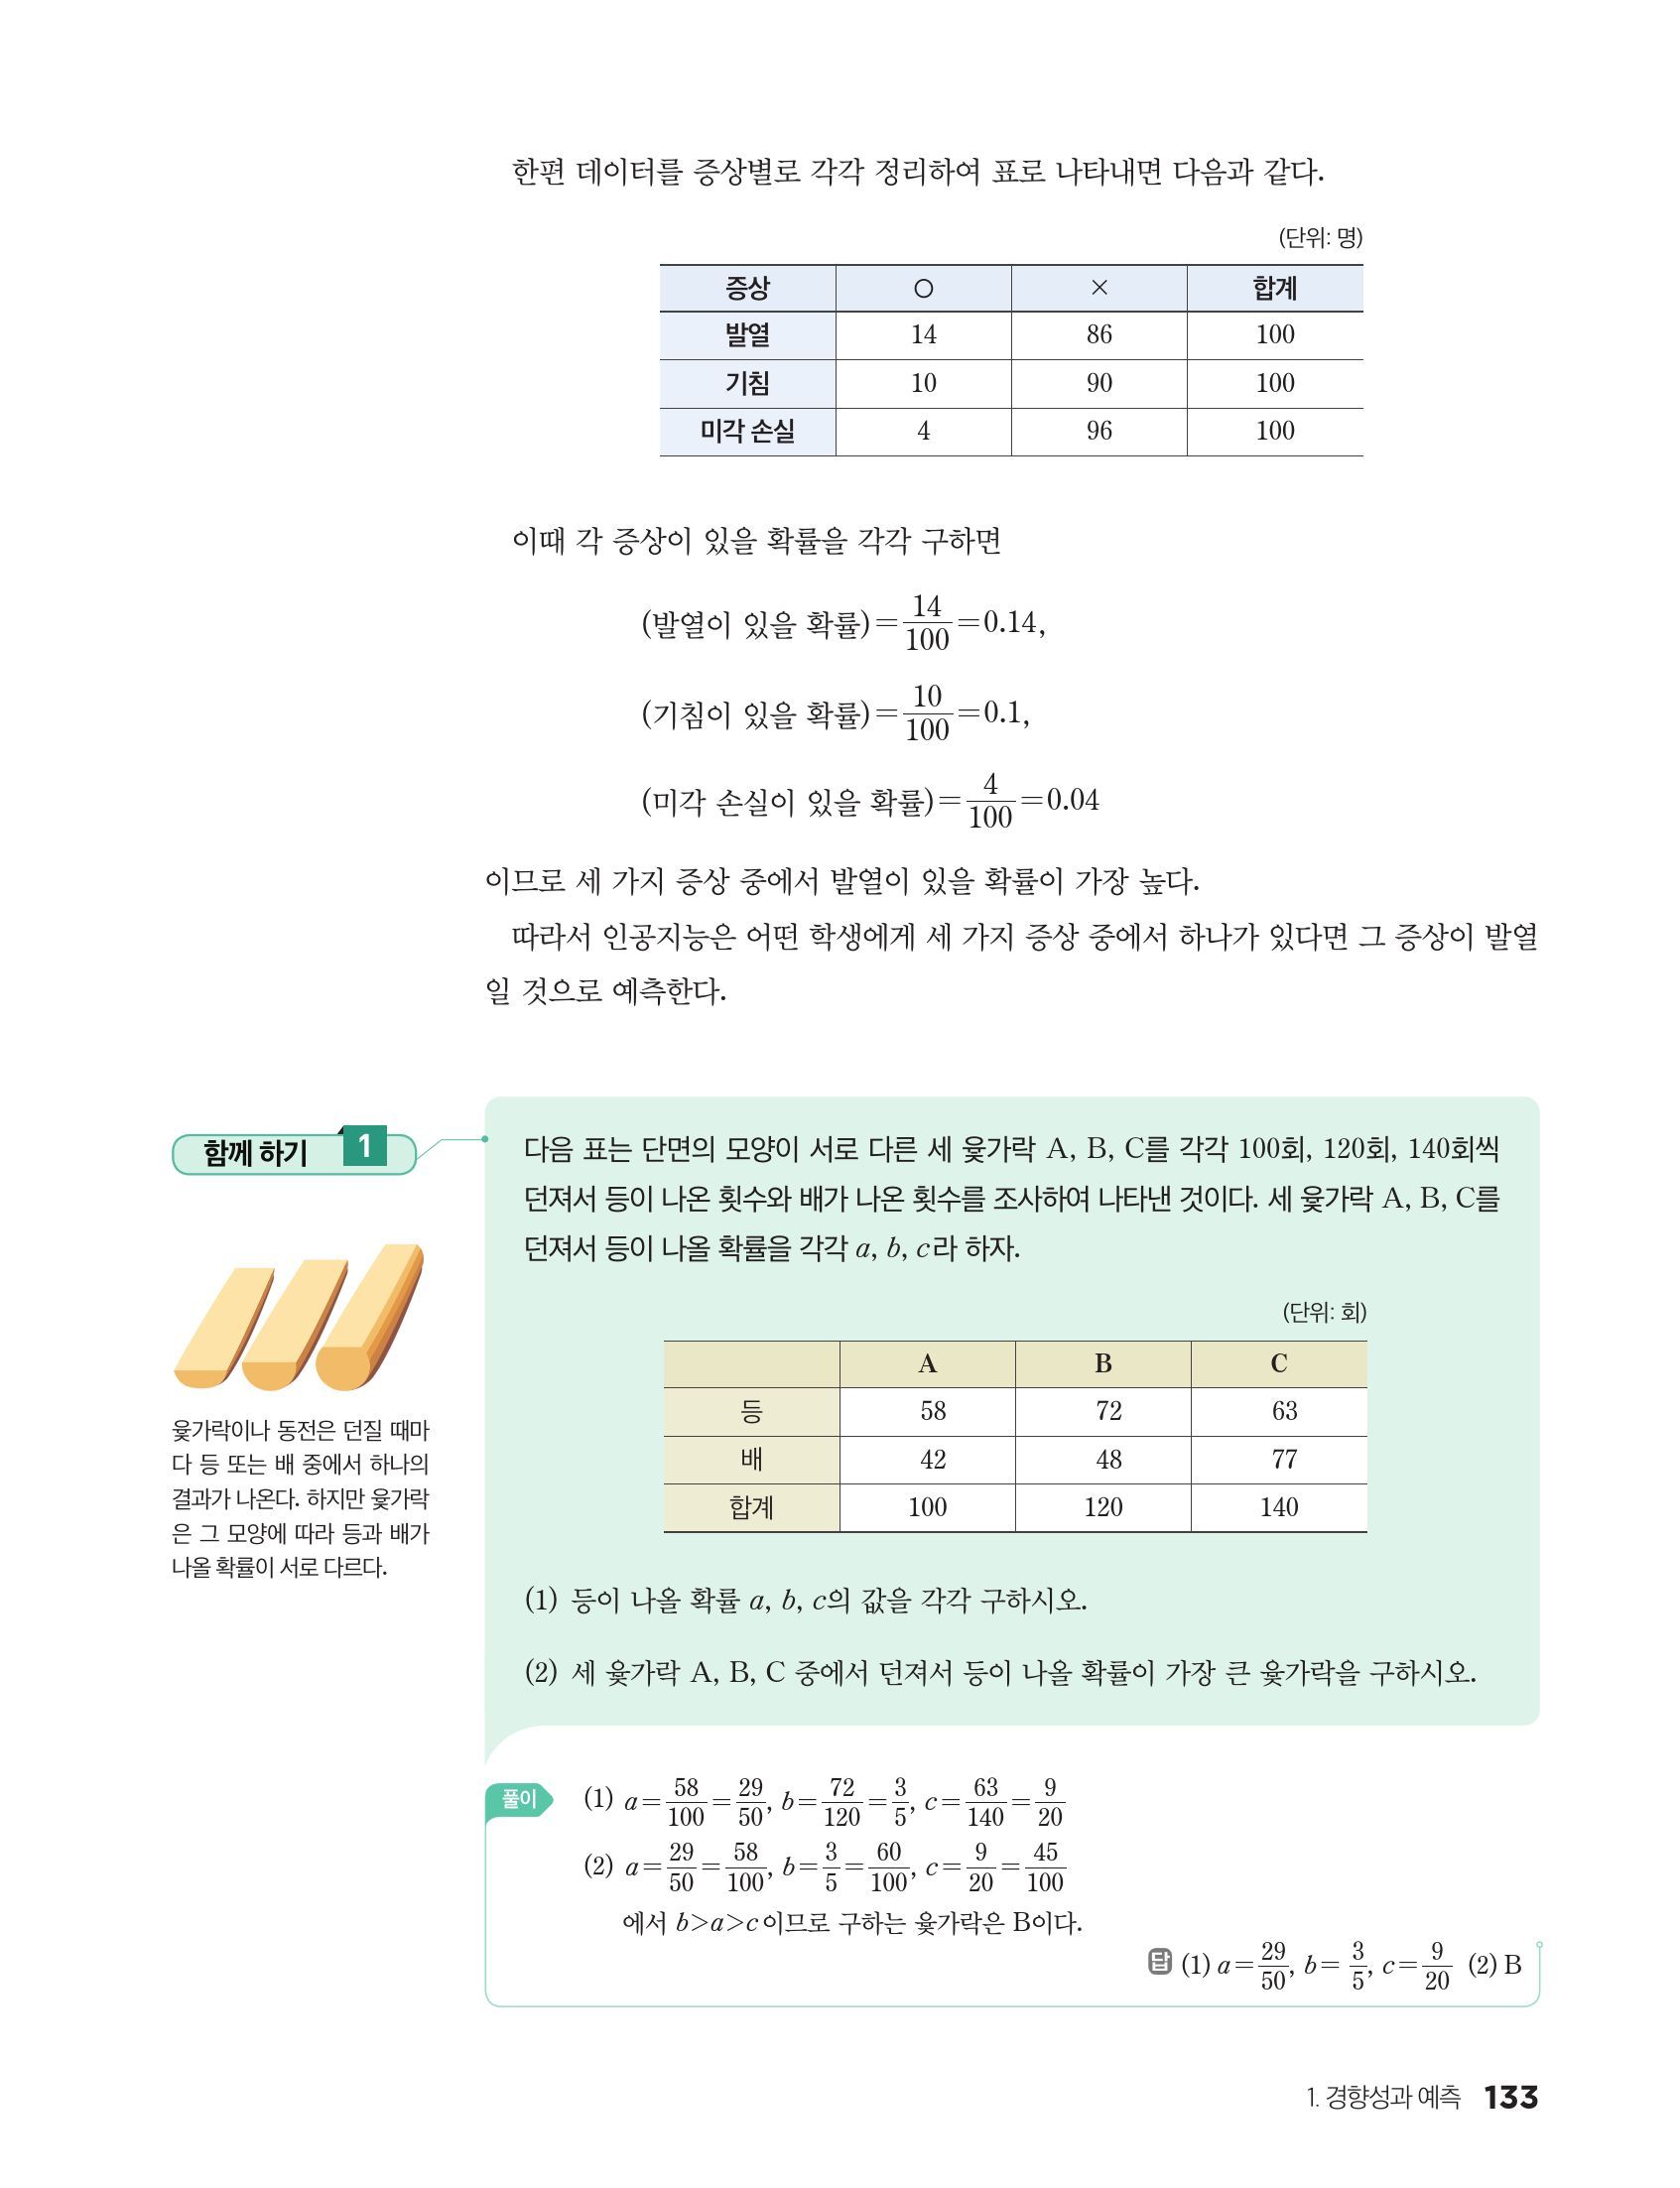
- 씨마스, 인공지능 수학 133쪽 — 표의 횟수를 전체 횟수로 나누어 ‘…일 확률’을 구하고, 여러 결과와 시행 횟수가 다른 대상을 비율로 비교하는 실제 면을 참고했다. 의료 판단 예시는 이 글에서 사용하지 않는다.
영상 노트
- 00:00 정답·오답 기록을 세기
- 00:45 식 (1) — 분모와 판정 기준, 교과서의 ‘…일 확률’
- 02:00 표, 식 (2)·(3), 그림 1 — 20칸 중 14칸
- 03:00 그림 2 — 누적 비율의 흔들림
- 04:00 식 (4) — 다음 50장의 어림 개수
- 05:00 ‘오늘’ 다음 낱말 표 — 가장 흔한 결과와 틀리는 비율 0.55
- 06:00 식 (5), 그림 3 — 개수와 비율의 순위가 바뀐다
- 07:30 식 (6), 그림 4 — 넓이로 보는 합친 비율
- 09:00 자료 없음과 관측 0 구별
지도에서의 위치
- 2026-11-16 · 에이전트 초안 — 조건·계산·가상 자료와 새 연습 작성
- 2026-11-17 · 전수 검수 반영 — 교과서의 '…일 확률' 표기와 다리, 다음 m번의 어림 개수, 여러 결과 중 가장 흔한 결과 고르기(다음 낱말 예), 크기가 다른 자료의 비율 비교, 시간 순서 확인과 합친 비율의 넓이 모형, 상대도수와 확률 질문, 비율을 채운다는 오해, 해보기 5문항 (에이전트 수정, 그림 1→4)
- 2026-11-17 · 전수 검수(에이전트 편집·독립 검증) 통과 — 주인 요청으로 완성으로 올림